OpenMP 编程学习:数据归属、同步与循环调度
我最初把 OpenMP 理解为“在循环前加一条指令就能并行”。实际做过求和、排序与前缀和练习后,才发现编译指令只是入口。真正决定程序是否正确、是否更快的,是哪些数据属于哪个线程、线程之间有没有依赖,以及同步和调度带来了多少额外成本。
1. 并行区域与循环分工要分别理解
parallel 建立一个团队执行并行区域;工作共享循环再把迭代分给团队中的线程。只建立并行区域,并不自动意味着每个线程只执行循环的一部分;手工划分时必须自己证明覆盖范围正确、没有遗漏或重复。
因此,比较手工划分与工作共享循环时,要让两边的并行区域数量、线程数、同步位置与工作量一致。原笔记中“手工划分更慢”的观察值得继续研究,但不能仅凭代码形式就归因为线程创建开销。
循环工作共享的定义及约束可参照 OpenMP Worksharing-Loop Constructs。
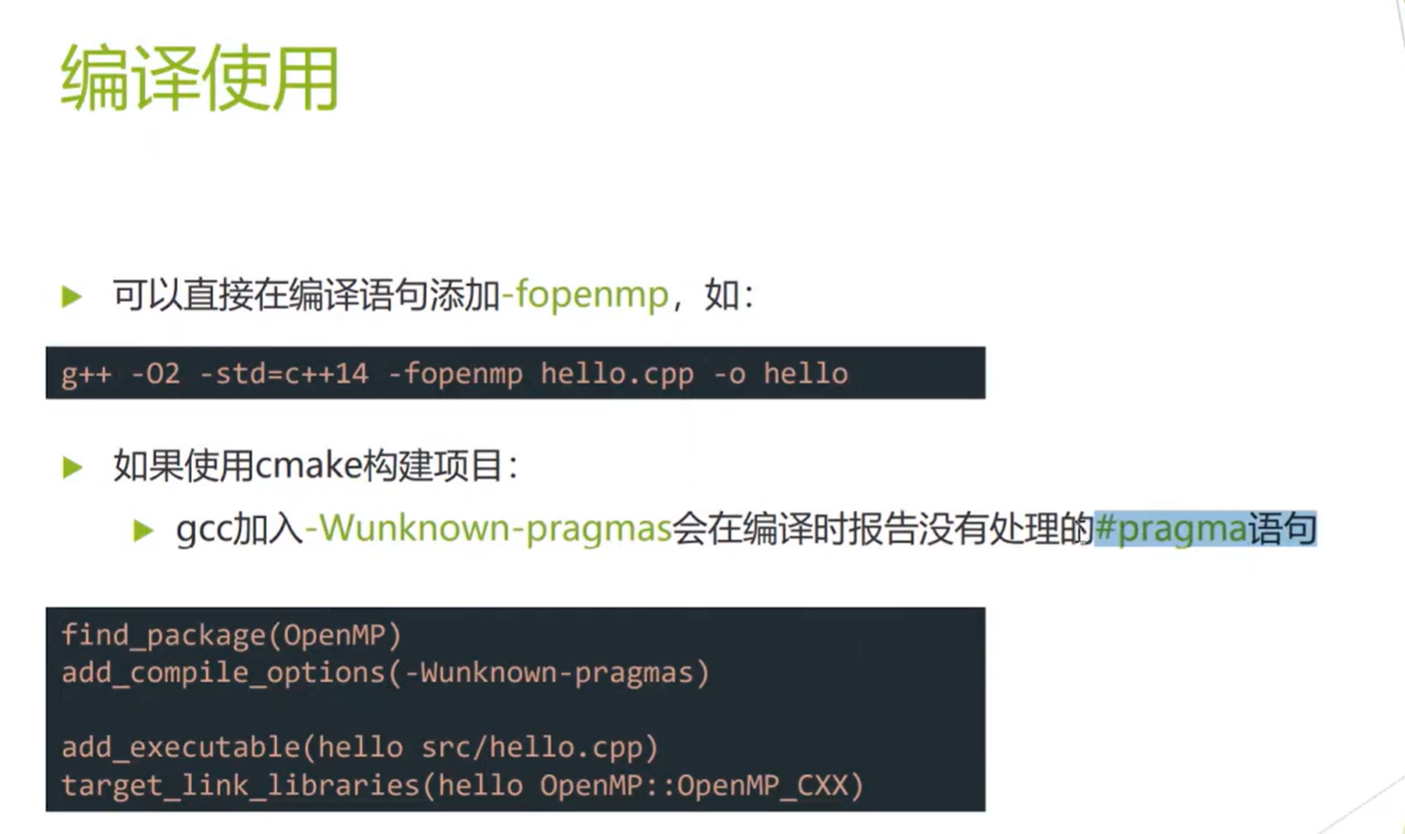
原笔记中的编译配置截图。
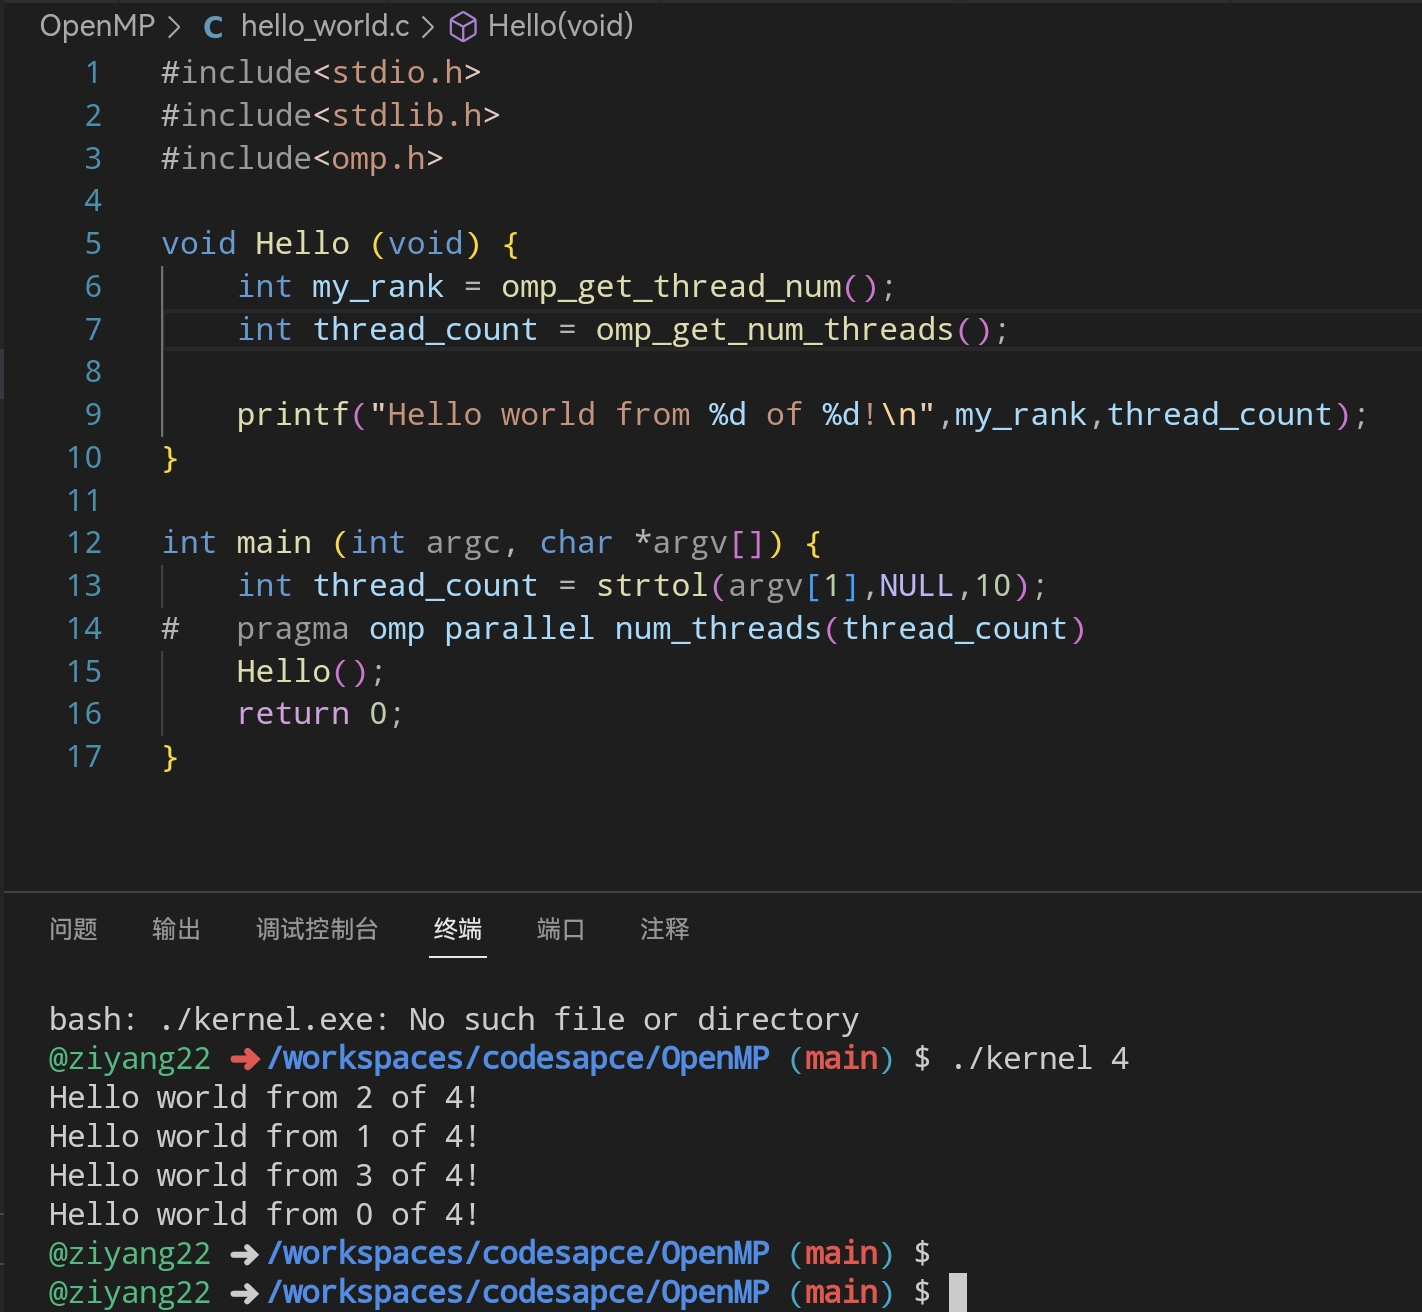
原笔记中的并行线程输出示例。
2. 先说明变量的数据归属
“多个线程能访问某个变量”和“这些访问不会产生冲突”是两个问题。共享变量只说明它们引用共享存储,不会自动为复合操作加锁。
| 属性 | 学习时应明确的问题 |
|---|---|
| shared | 哪些线程读写同一个对象,写入是否可能互相覆盖? |
| private | 每个任务获得自己的对象后,初值是否已经定义? |
| firstprivate | 是否需要从进入区域前的原对象初始化副本? |
| reduction | 是否希望将各部分结果按指定运算组合起来? |
private 不意味着把原对象的值复制过去;firstprivate 才在私有化基础上提供从原对象初始化的语义。原笔记中相关解释已合并,避免读者把两者混用。private、firstprivate
对于指针,还要单独检查指针指向的对象。指针变量本身成为私有副本,不代表它指向的数据也自动变成独立副本。
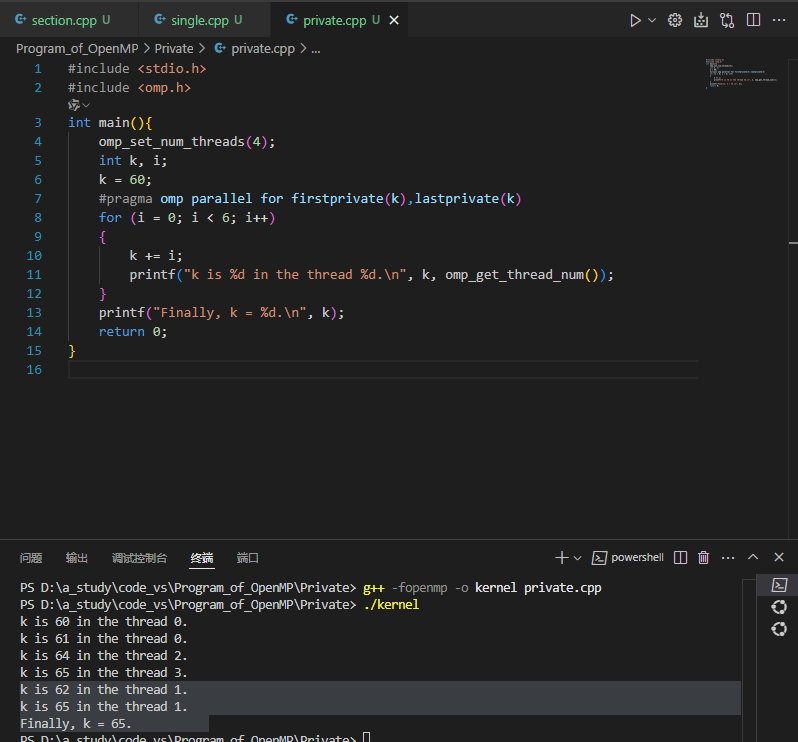
用于对照变量数据属性的历史示例;截图本身不构成通用正确性证明。
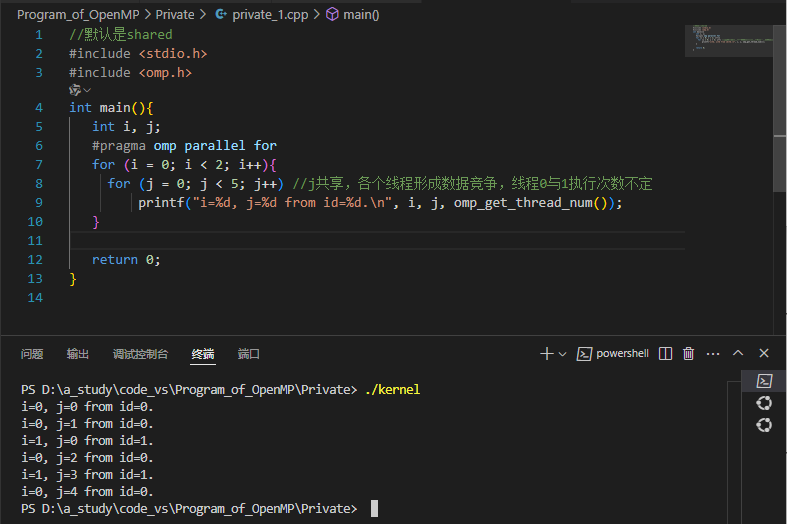
原始学习截图,输出顺序受执行情况影响。
3. 求和、临界区与原子操作
原笔记用梯形积分和求和理解归约,这是一条很好的学习路线:先得到串行结果,再理解每个线程的局部贡献如何合并。
归约将私有部分与结果组合规则联系起来。浮点结果可能受组合顺序影响,不能只用“与串行按位完全一致”这一条标准判断所有浮点归约。规范并不保证组合表达式的执行顺序。OpenMP Reduction Expressions
critical、atomic 与锁不能当作同义词。选用时应先确定需要保护的对象:是一个受支持的原子访问模式、一段多语句操作,还是跨越更复杂控制流的资源。给某一处写入加保护,也不会自动修复其他未同步的访问。
原文的 #pragma parallel 缺少 omp,应当明确区分指令拼写错误与算法本身的问题,这里不直接复用那段未验证代码。
4. 调度策略应结合工作量与局部性
| 策略 | 主要分配方式 | 值得观察的代价 |
|---|---|---|
| static | 事先确定分配;指定 chunk 时按块分给线程 | 工作不均时可能等待,细粒度划分可能影响局部性 |
| dynamic | 线程完成当前块后继续获取工作 | 分配与协调开销 |
| guided | 动态分配,块大小随剩余工作调整 | 块变化与任务分布是否匹配 |
| runtime | 由运行时调度设置决定 | 实际采用的设置是否记录完整 |
这张表描述的是理解调度的入口,不是性能排名。guided 不能简单写成“只适用于单次迭代计算量逐渐减少”,dynamic 也不能自动消除算法依赖。OpenMP 5.2:schedule Clause
原笔记中的环境变量赋值带了等号两侧空格。用于 shell 的写法应是 export OMP_SCHEDULE="static,1"。要让该设置影响目标循环,还需让循环使用运行时调度;未指定调度时不能无条件声称某个固定策略在所有实现中都成立。
5. 数据依赖优先于调度优化
在给循环加并行指令前,应先写清每轮读什么、写什么,以及这些位置是否属于其他迭代的输入。某次输出恰好正确,不足以证明没有数据竞争。
原始排序练习适合用来理解这一点。相邻元素交换如果共享边界,就必须考虑操作顺序;不能把所有交换放在同一个并行循环里。奇偶阶段的划分提供了一种分析入口,但原笔记中的完整实现仍应独立测试。
前缀和也不是普通逐元素求和。它的每个输出包含前面多个输入的信息,需要明确算法阶段及阶段之间的同步。原笔记把 OpenMP 前缀和标为“反向优化”,这一观察应保留;没有完整输入、线程数与计时信息前,不宜把它推广成“OpenMP 不适合前缀和”。
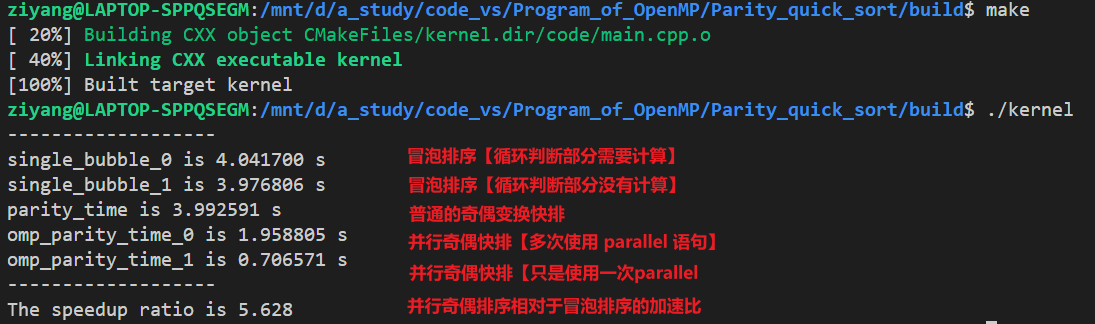
原笔记保留的排序计时,不与其他硬件或代码版本直接横比。
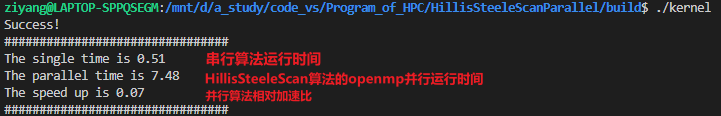
原笔记中的性能回退现象;截图中的单次记录不能作为通用性能结论。
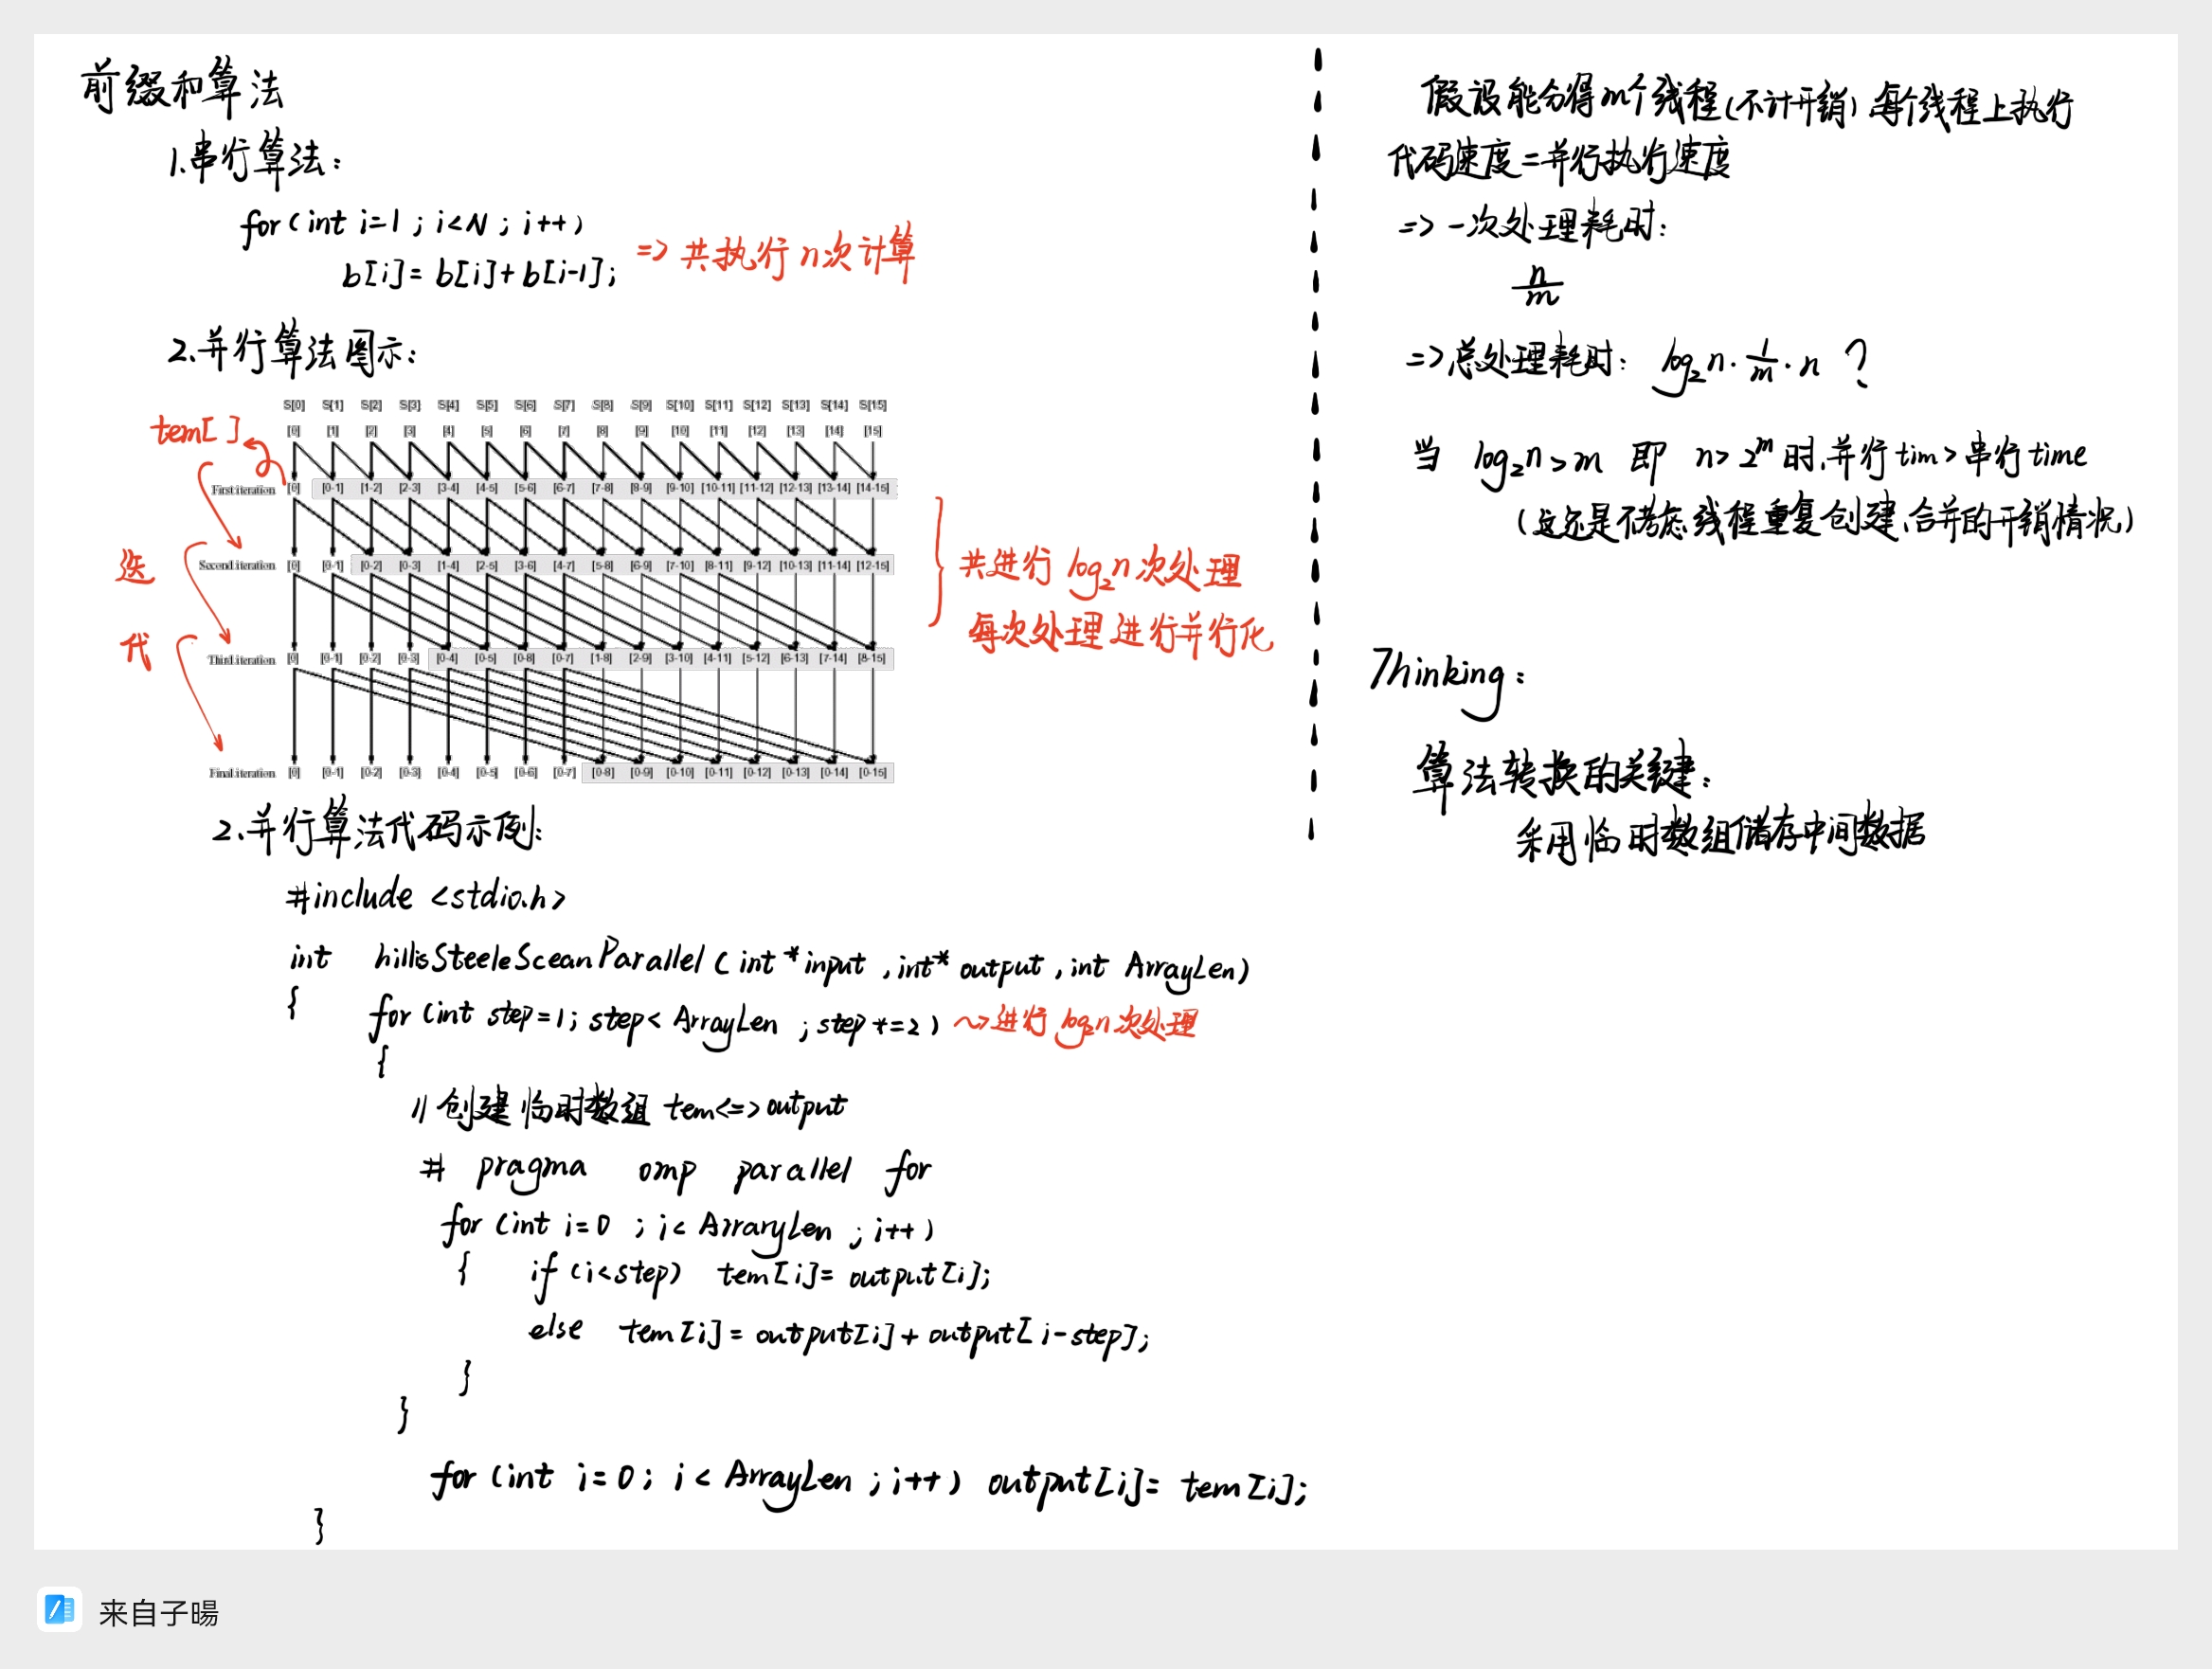
原笔记中的前缀和分析手稿。
6. 把任务与同步放回具体场景
原笔记收集了 sections、single、task depend 与生产者—消费者问题。它们可以作为进阶篇:先说明任务如何产生、由谁执行,再说明什么条件表示依赖满足、队列不再变化或全部任务结束。
本篇保留这些知识点的位置,但不把尚空着的章节扩写成已经完成的实践。尤其是生产者—消费者终止检测与锁的使用,需要结合实际代码说明;用一个“隐式屏障”概念无法覆盖所有同步需求。
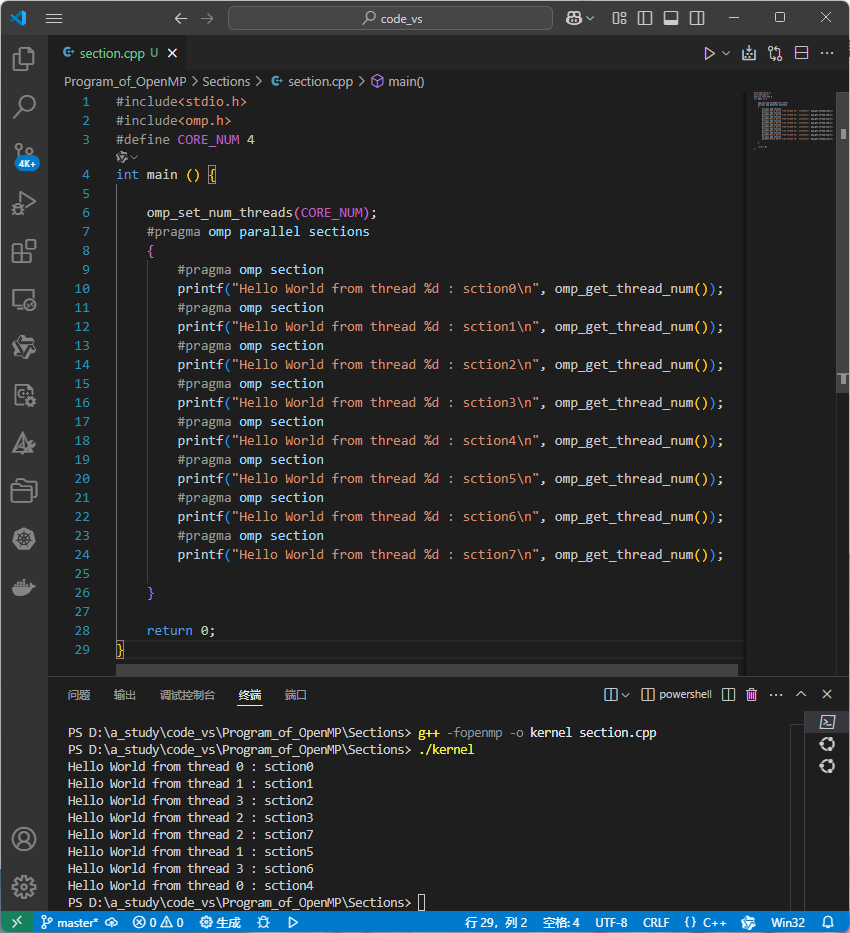
历史 sections 学习示例,用于观察任务分配。
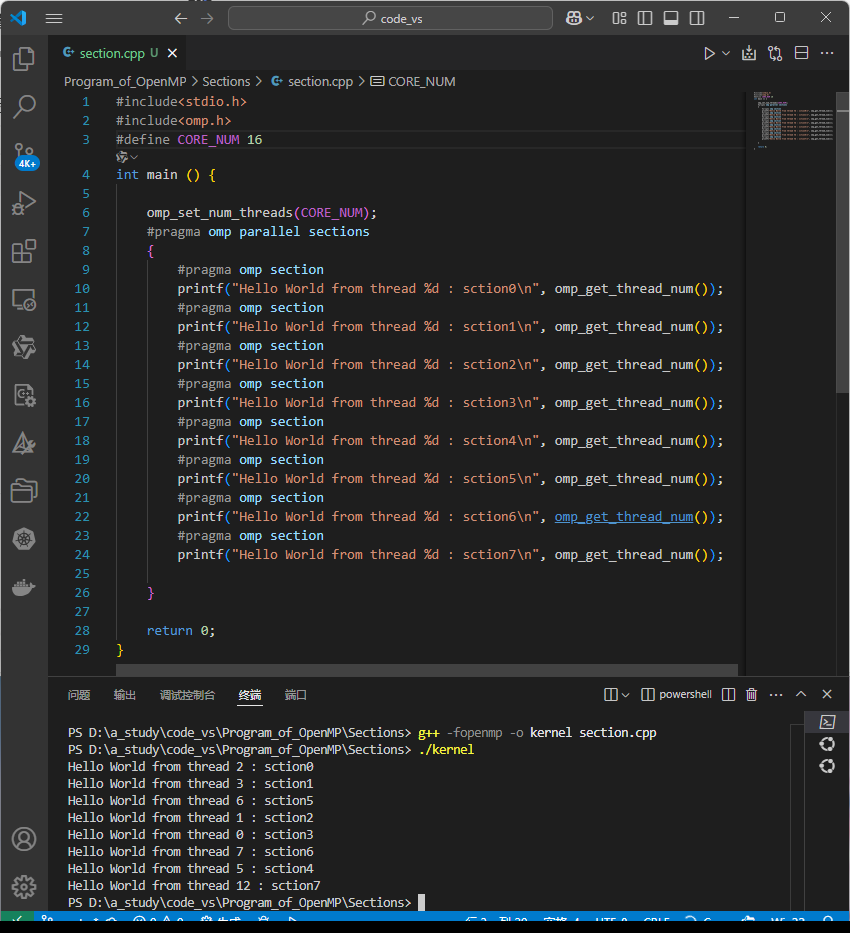
不能由这份输出推断实现一定创建或回收了哪些底层工作线程。
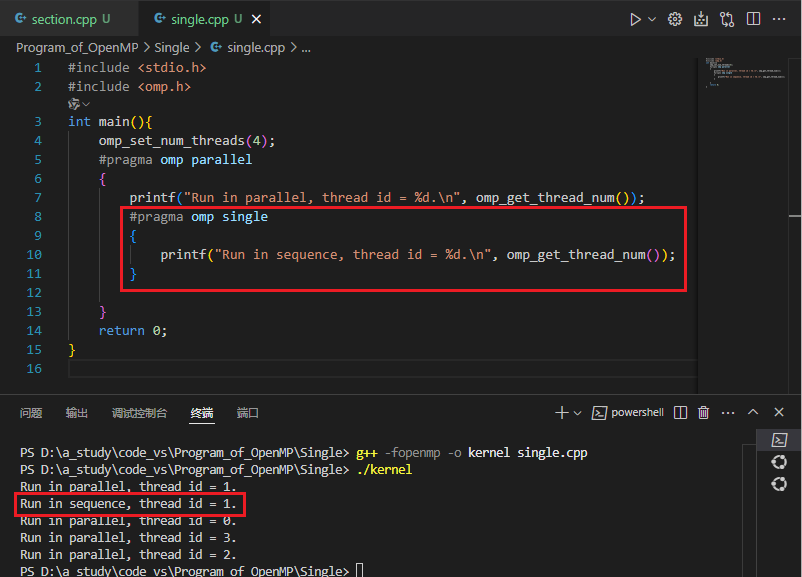
原笔记中关于 single 执行的学习记录。
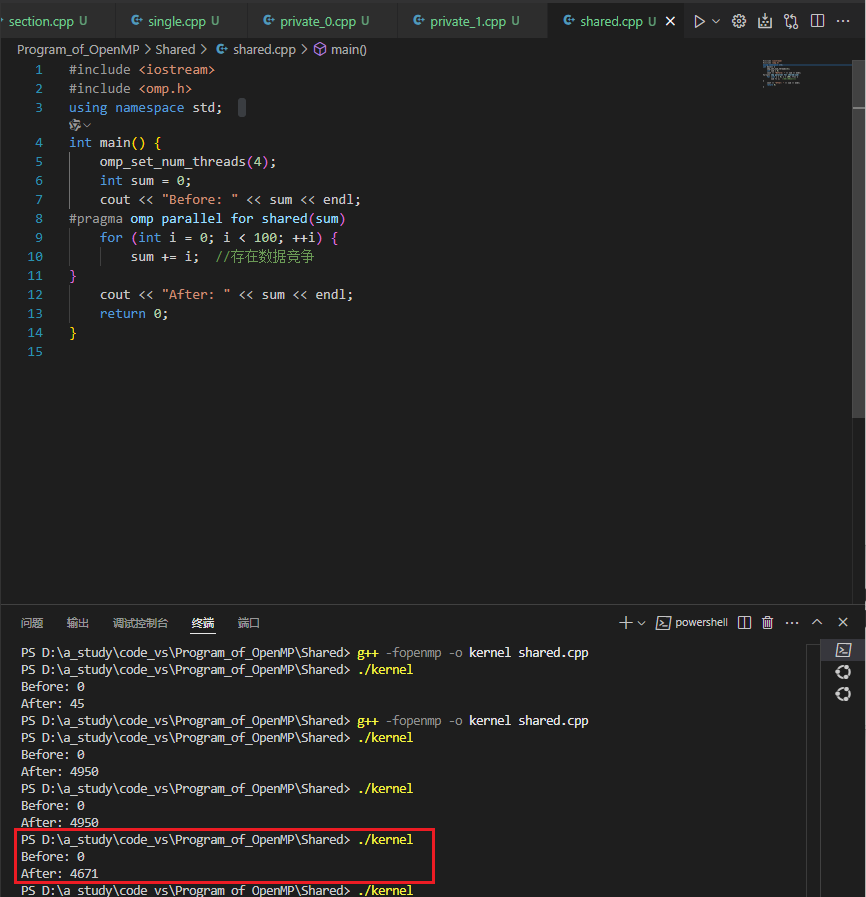
这是保留的错误示例,不能直接当作可复用的正确实现。
7. 怎样判断并行化真的有效?
我会给每次比较保留串行基准、输入规模、线程数、调度策略、编译方式和结果检查。多次运行时先确认完成的是同一份工作,再观察时间分布。
如果线程数增加却没有变快,下一步是分开检查负载不均、同步次数、访存局部性与线程调度等因素,而不是直接认定某个 OpenMP 子句效率低。原笔记还列出了缓存一致性与伪共享,但内容基本未展开;它们适合后续补做实验,本稿不把它们写成已经验证的根因。
资料与记录说明
原始笔记:FlowUs 页面。本文将原来的重复问答按主题组织,保留仍待验证的问题。
文中的运行截图和手稿来自历史学习记录;本次整理没有重新运行这些实验,也没有新增实测加速结论。
部分原始截图是故意保留的错误示例。一次输出正确,不能证明不存在数据竞争。