Jacobi-2D 优化报告
1. 基础测评
首先,编写native kernel 在不同数据集下批量运行,获得性能曲线
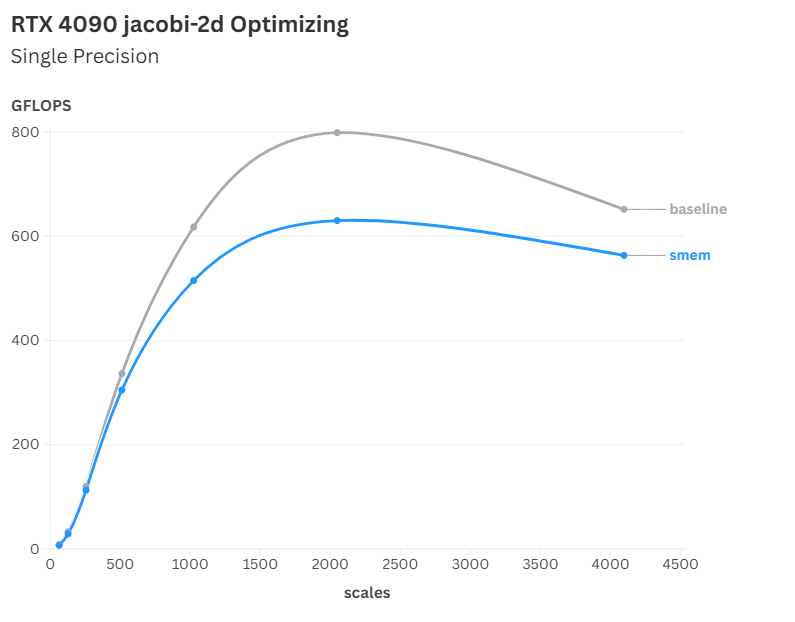
目前数据集采样模式下的性能曲线图1.1所示
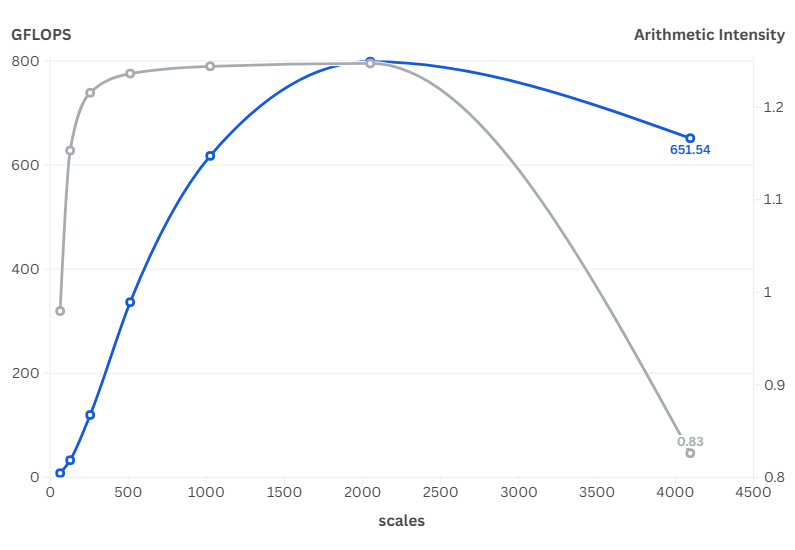
图1.1
下面对于native kernel 性能进行分析
2. 理论分析
2.1 bound 定位
计算得出AI理论值为0.208
(N^2)5/(N^2)(5+1)*4
确定为访存密集型算子
这也是一种判断方法
理论分析
TheoreticalFLOPs = N^2*(4+1)
TheoreticalBytes = (N^2)*(5+1)*4
设置优化的基准矩阵大小为2048*2048,则根据计算以及硬件指标可以获得以下数据:
选用2048大小数据是因为2048^2*2 = 8MB,大小在L1 cache 和 L2 cache之间
TheoreticalFLOPs = N^2*(4+1) = 20,971,520 FLOPs
TheoreticalFLOPS_Peak = 82.58 TFLOPS
TheoreticalComputeTime = TheoreticalFLOPs / TheoreticalFLOPS = 0.254 μs
TheoreticalBytes = (N^2)*4 = 16,777,216 Bytes
TheoreticalBandwidth = 1.01 TB/s
TheoreticalMemTime = TheoreticalBytes / TheoreticalBandwidth = 15.11 μs
可以看到,理论上这是一个memory bound kernel
2.2 native kernel 分析
native版本
bound定位
根据ncu采样报告,我们可以获得如下指标:
RealTime = 25.92 us
dram__bytes_read.sum = 16.777.472 byte
dram__bytes_write.sum = 0 byte
dram__bytes.sum = 16.777.472 byte
Real_FLOPS = 807.506 GFLOPS
Real_Bandwidth = 647.28 GB/s (对应计算load_time= 25.32 μs)
可以看到缓存所用时间占据了 RunTime 的绝大部分,native kernel 是 memory bound
memory_bound
原因分析
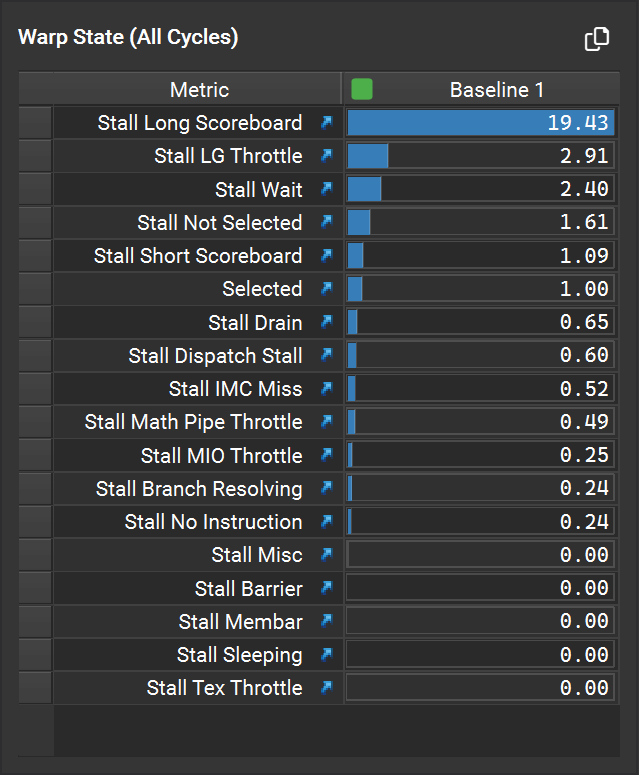
查看Warp State Statistics,发现Stall Long Scoreboard数值较大
Warp was stalled waiting for a scoreboard dependency on a L1TEX (local, global, surface, texture) operation. Find the instruction producing the data being waited upon to identify the culprit. To reduce the number of cycles waiting on L1TEX data accesses verify the memory access patterns are optimal for the target architecture, attempt to increase cache hit rates by increasing data locality (coalescing), or by changing the cache configuration. Consider moving frequently used data to shared memory. Warp 在等待记分牌依赖于 L1TEX(本地、全局、表面、纹理)作时停滞不前。找到生成正在等待的数据的指令,以识别罪魁祸首。为了减少等待 L1TEX 数据访问的周期数,请验证内存访问模式是否适合目标架构,尝试通过增加数据局部性(合并)或更改缓存配置来提高缓存命中率。考虑将常用数据移动到共享内存。
优化方案分析
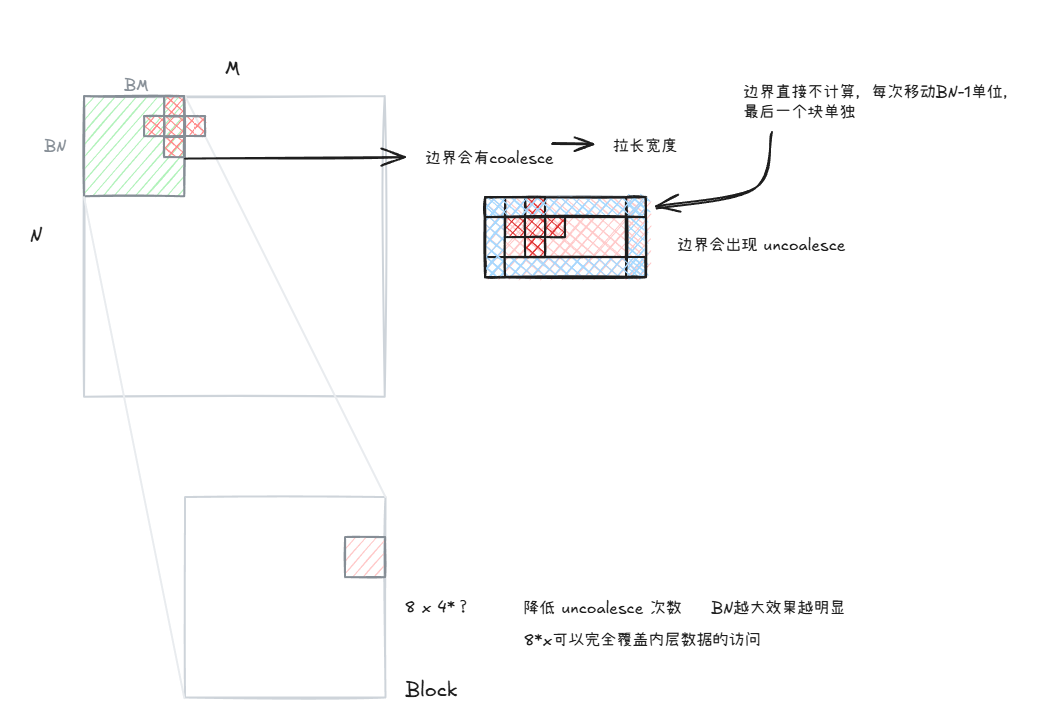
- 全局合并内存访问
切换索引计算方式/固定BlockSize
- SMEM使用
可以先以 8x4* 的大小加载一块数据【确保块内线程coalesce】,每次迭代移动BM-1单位,最后一个线程块特殊处理
3. 逐级优化策略及实验结果
3.1 SMEM 共享内存使用
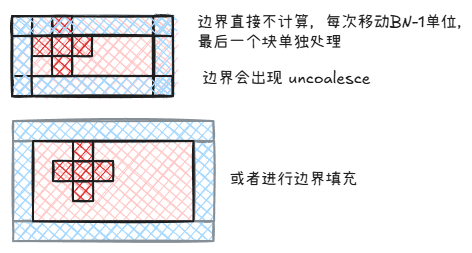
这个版本实现了朴素的共享内存访问,即每个线程块储存对应量数据到SMEM中,提高数据读取效率
注意,为了确保每个线程都能正确处理数据,这里格外加载了四周的边界数据(引入了divergence,double load time)
方案示意图
核心代码
    // --- 1. 索引计算 ---
    // 块内局部索引
    int tx = threadIdx.x;
    int ty = threadIdx.y;

    //网格起始全局索引
    int bx = blockIdx.x * BM;
    int by = blockIdx.y * BN;

    // 全局索引
    int col = bx + tx;
    int row = by + ty;

    // --- 2. 共享内存声明 ---
    // 为了计算一个 BLOCK_DIM_X * BLOCK_DIM_Y 的数据块,我们需要一个1像素的边界(光环)
    // 因此共享内存的大小是 (BLOCK_DIM_X + 2) x (BLOCK_DIM_Y + 2)
    __shared__ DATA_TYPE As[BN + 2][BM + 2];

    // --- 3. 从全局内存加载数据到共享内存(包含光环区域) ---
    // 加载数据块的中心部分
    // 每个线程负责加载一个点到共享内存的中心区域
    // 注意边界检查,防止读取全局内存越界
    if (row < n && col < n) {
        As[ty + 1][tx + 1] = A[row * n + col];
    }

    // 加载额外边界区域
    // 只有块边缘的线程需要执行额外的加载操作
    // 加载左边界光环
    if (tx == 0 && col > 0 && row < n) {
        As[ty + 1][0] = A[row * n + (col - 1)];
    }
    // 右边界
    if (tx == BM - 1 && col < n - 1 && row < n) {
        As[ty + 1][BM+ 1] = A[row * n + (col + 1)];
    }
    // 上边界
    if (ty == 0 && row > 0 && col < n) {
        As[0][tx + 1] = A[(row - 1) * n + col];
    }
    // 下边界
    if (ty == BN - 1 && row < n - 1 && col < n) {
        As[BN + 1][tx + 1] = A[(row + 1) * n + col];
    }

    // --- 4. 线程同步 ---
    __syncthreads();
性能结果图
相关性能指标:
RealTime = 25.92 us → 32.58 us
dram__bytes_read.sum = 16,777,344 byte
Real_FLOPS = 642.515 GFLOPS
Real_Bandwidth = 647.28 GB/s → 515.02 GB/s (对应计算load_time= 31.8us)
依旧是 memory bound
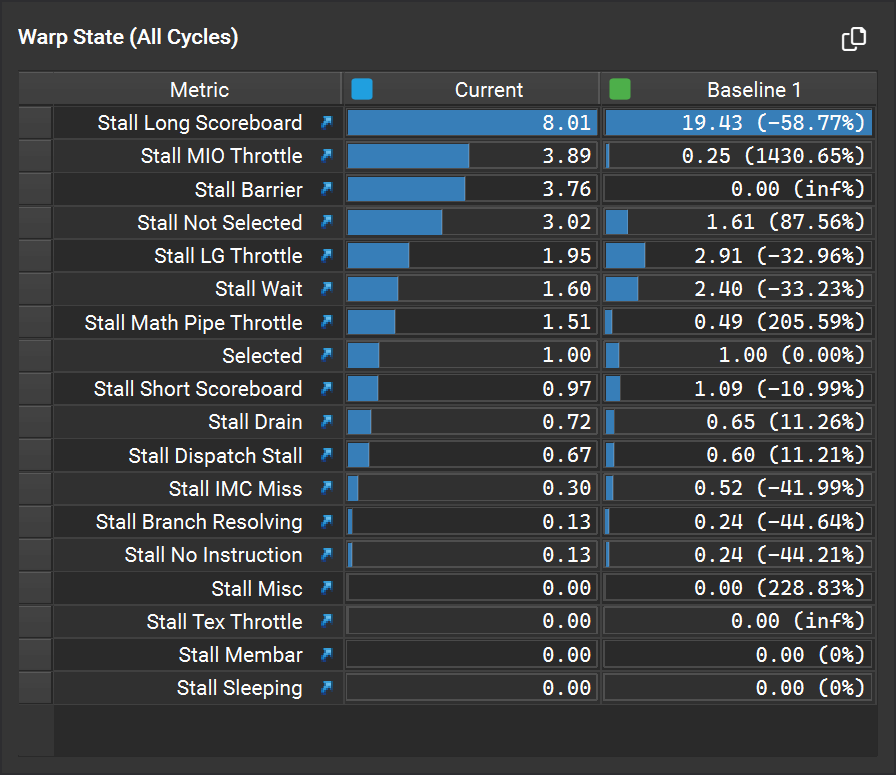
Warp State 中 Stall LG Throttle 占比由19.43减少至8.01cycles
预料之中新增Barrier Stall部分,MIO Stall部分增加
Stall MIO Throttle:
Warp was stalled waiting for the MIO (memory input/output) instruction queue to be not full. This stall reason is high in cases of extreme utilization of the MIO pipelines, which include special math instructions, dynamic branches, as well as shared memory instructions. When caused by shared memory accesses, trying to use fewer but wider loads can reduce pipeline pressure.Warp 因等待 MIO(内存输入/输出)指令队列不空而阻塞。这种阻塞原因在使用 MIO 管道极端情况下较为常见,包括特殊数学指令、动态分支以及共享内存指令。当由共享内存访问引起时,尝试使用更少但更宽的加载可以减少管道压力。
PS:为什么SMEM版本运行时间及FLOPS相较于baseline下降
SMEM版本中涉及到额外边界数据的加载,此部分只有少数线程访问全局内存,为了满足这些线程的数据读取要求,硬件仍然需要从 L2/DRAM 搬运一整个 128 字节的缓存行。此阶段开销增加(double),尽管后面在SMEM中数据读取时间减少,但总体增大于减,收益为负
因此要解决这个问题,可以从减少零散数据读取的方向考虑
还有可能的原因如下:
为什么SMEM版本运行时间以FLOPS相较于baseline下降
1. Baseline (无共享内存) 为何如此强大?
您最初的 jacobi-2d 内核(我们称之为 baseline)虽然代码简单,但它在现代 GPU 架构上却能表现出惊人的性能,主要得益于以下两点:
完美的内存访问合并 (Coalescing):正如我们之前讨论的,您的
baseline内核中,一个 Warp 内的 32 个线程访问的都是连续的内存地址。这使得 GPU 硬件可以将 32 次独立的读取请求合并成一次或几次大的内存事务,极大地利用了内存带宽。高效的 L1/L2 缓存系统:这是最关键的一点。像 RTX 4090 这样的现代 GPU 拥有非常大且智能的 L1 和 L2 缓存。当您的
baseline内核执行时:一个 Warp 的线程请求读取
A[idx]到A[idx+31]的数据。硬件从 DRAM 中一次性读取一个或多个缓存行(Cache Line)(例如 128 字节)到 L2 和 L1 缓存中,这个缓存行里不仅包含了当前需要的数据,还包含了周围的数据。
当线程接着需要读取
A[idx-1]、A[idx+1]、A[idx-n]等邻居数据时,这些数据有极大的概率已经在 L1/L2 缓存中了(即缓存命中 Cache Hit)。因此,大量的内存读取请求实际上是由飞快的 L1/L2 缓存响应的,真正访问缓慢的 DRAM 的次数被大大减少了。
结论:您的 baseline 版本,实际上是在被动地、由硬件自动地享受着类似共享内存带来的好处。
2. 共享内存 (smem) 版本的额外开销
您实现的共享内存版本,在逻辑上是“手动”完成了缓存的工作。虽然这在理论上是最佳选择,但它也引入了不可避免的额外开销:
显式的加载指令:您需要编写额外的代码将数据从全局内存加载到共享内存 (
As[ty + 1][tx + 1] = A[...]),以及加载光环区域。这些都是需要执行的指令,会消耗计算周期。线程同步开销 (
__syncthreads()):这是一个阻塞点。所有线程必须在这里等待,直到最慢的那个线程完成数据加载。这个等待过程会引入延迟(Latency)。可能降低的占用率 (Occupancy):共享内存版本的内核通常比
baseline版本更复杂,可能会使用更多的寄存器(Register)。如果每个线程块使用的共享内存或寄存器过多,就会限制一个 SM(Streaming Multiprocessor)上能同时运行的线程块数量,这被称为占用率下降。较低的占用率会削弱 GPU 通过线程切换来隐藏内存延迟的能力。
结合您的性能图进行分析
从您提供的性能图中(baseline 灰色线 vs smem 蓝色线),我们可以清晰地看到:
在所有尺度 (scales) 上,
baseline版本的 GFLOPS 都高于smem版本。两条线的性能曲线形状非常相似,都在 N 约等于 2500 时达到峰值。
这完美地印证了我们的分析:
baseline版本的代码简单、开销小,并且其内存访问模式完美契合了 RTX 4090 强大的缓存架构,硬件自动为它处理了大部分的数据复用。smem版本虽然在逻辑上更“优化”,但它引入的加载、同步等开销,超过了手动管理内存所能带来的、相对于硬件缓存的微小优势。最终,开销 > 收益,导致了 GFLOPS 的下降。
结论:什么时候共享内存依然是“神器”?
这次的测试结果并不意味着共享内存没有用,恰恰相反,它告诉我们要根据算法和硬件的特点来选择优化策略。共享内存在以下情况中依然是不可替代的:
数据重用模式复杂:当数据访问不是像
jacobi-2d这样规整的邻居访问,而是更复杂的、无规律的模式时,硬件缓存的预测可能会失效,此时手动控制的共享内存将发挥巨大威力(例如矩阵乘法、FFT 等)。需要多次重复读取同一数据:如果一个块内的线程需要反复读取共享内存中的同一块数据进行多次计算,那么一次加载、多次复用的收益将远超开销。
老旧的 GPU 架构:在 L1/L2 缓存较小、效率较低的老式 GPU 上,
jacobi-2d的共享内存版本几乎肯定会比baseline版本快得多。
总而言之,您遇到的情况是一个非常好的学习案例,它证明了在现代 GPU 上,一个简单、干净、内存访问合并良好的 baseline 代码,其性能可能已经非常接近硬件的理论上限,任何“画蛇添足”的优化都可能因为引入额外开销而得不偿失。
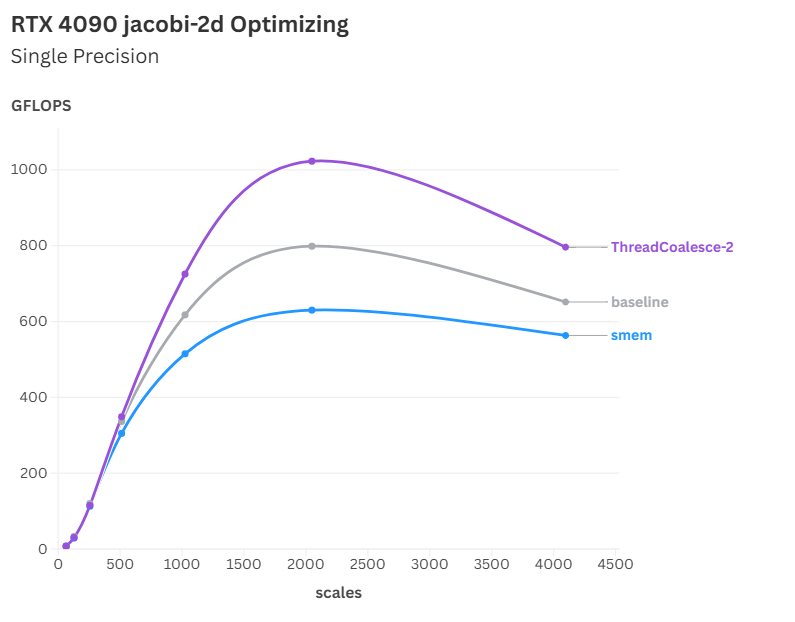
3.2 ThreadCoalesce-2 单线程多任务
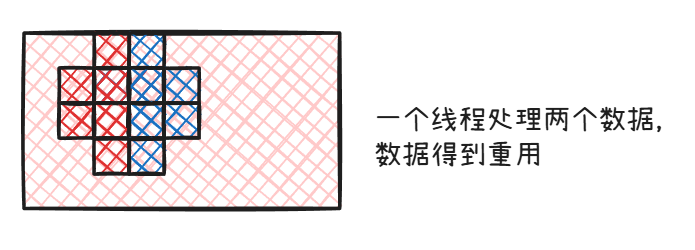
jacobi-2d一个数据的更新依赖于周围数据值,单个线程更新临近的多个数据时,会重用中心部分数据
性能结果图
相关性能指标:
RealTime = 25.92 us → 20.29 us
dram__bytes_read.sum = 16,777,472 byte
Real_FLOPS = 1,031.672 GFLOPS
Real_Bandwidth = 647.28 GB/s → 826.97 GB/s (对应计算load_time= 19.8 us)
PS
集群任务最好串行提交
今天在运行批量测试脚本的时候发现2048数据集的统计运行时间和1024统计时间相近,但是实际采样结果二者相差较大,怀疑可能是任务同时提交导致统计的数据出现了问题