CUDA Bank Conflict:从地址映射到 Padding
本文从我原来的 Bank conflict 笔记整理而来,重点回答三个问题:冲突发生在哪里、怎样从地址判断冲突,以及为什么 padding 有时有效、有时完全无效。
1. 先限定讨论对象
这里讨论的是 CUDA 共享内存访问。为了把规律讲清楚,下面的地址演算限定为:32 个 bank、连续 32 位字映射到连续 bank,一个 warp 中的线程分别访问一个 float。更宽的数据、向量化指令和不同架构需要按实际请求拆分重新分析,不能机械套用简化模型。
对这一模型,bank 编号可以写成:
这里的 4 表示一个 32 位字占 4 字节,并不表示某个 bank 总共只有 4 字节容量。bank 可以包含许多映射到同一编号的地址。NVIDIA 编程指南
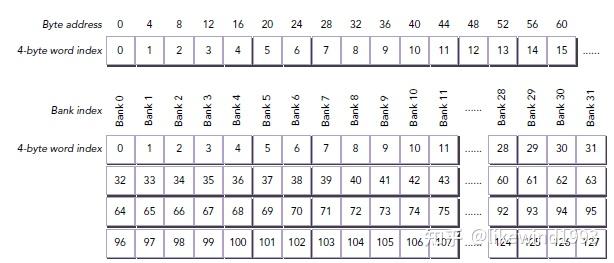
原笔记引用的地址映射示意,来源:CUDA Shared Memory。
2. 冲突由同一请求中的地址关系决定
判断时,需要同时问两个问题:这些访问是否落在同一个 bank,以及它们是否指向同一个位置。原笔记把这些情况混在一起,容易误以为“同一个 bank 就一定冲突”。
| 访问关系 | 应怎样理解 |
|---|---|
| 不同线程访问不同 bank | 简化模型下可以并行服务 |
| 多个线程读同一个位置 | 可利用广播,不应按不同位置的冲突处理 |
| 多个线程访问同一 bank 的不同位置 | 请求可能被拆分,降低有效吞吐 |
| 多个线程普通写入同一位置 | 不能当作可靠的结果合并方法,需要另外考虑数据竞争 |
不同 warp 的请求不会合并成一条 warp 指令来计算 bank conflict;这不意味着不同 warp 永远不会竞争共享内存吞吐。原笔记中的“不同 warp 不会在同一时间访问同一 bank”应收紧为前一种说法。CUDA Best Practices:Shared Memory and Memory Banks
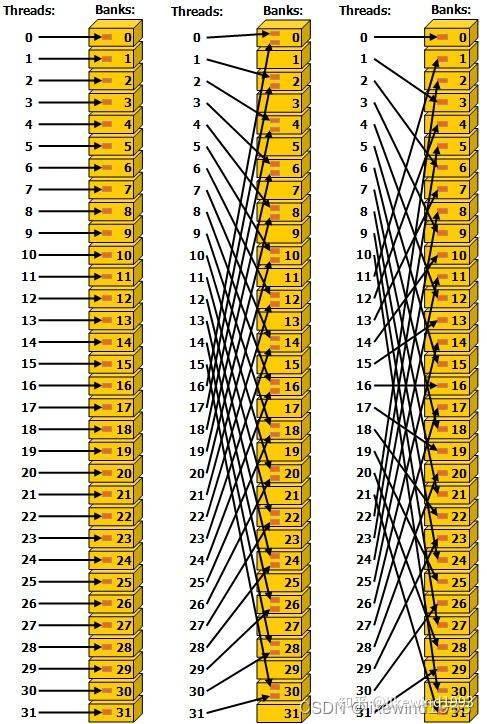
原笔记引用的 NVIDIA CUDA 编程指南示意图;结合上文给定的访问条件理解。
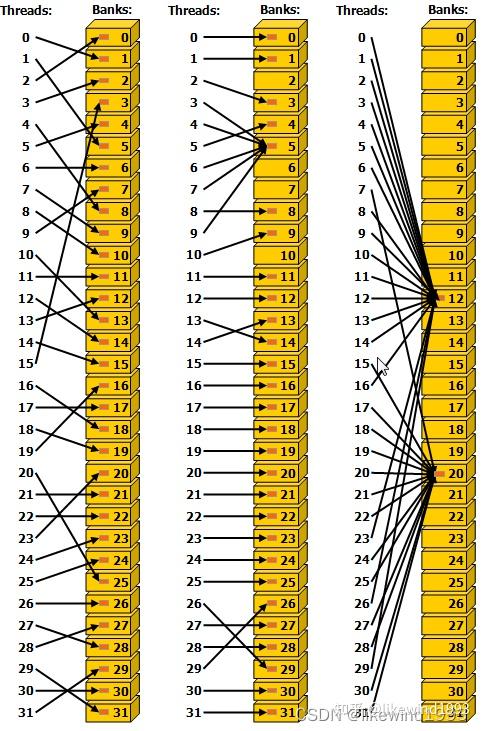
原笔记引用的 NVIDIA CUDA 编程指南广播示意;图中的读取广播不能推广为普通并发写入的正确性保证。
3. 用地址表理解 stride
设 lane 编号为 t,访问元素为数组中的 stride×t。忽略统一的起始偏移时,bank 编号就是 (stride × t) % 32。
| stride | lane 0~3 的元素下标 | 对应 bank | 简化模型下的现象 |
|---|---|---|---|
| 1 | 0、1、2、3 | 0、1、2、3 | 32 个线程覆盖 32 个 bank |
| 2 | 0、2、4、6 | 0、2、4、6 | 32 个线程覆盖 16 个 bank,可出现两路冲突 |
| 32 | 0、32、64、96 | 0、0、0、0 | 地址不同,但全部映射到同一 bank |
| 33 | 0、33、66、99 | 0、1、2、3 | bank 编号重新分散 |
这张表是按给定假设计算出来的地址关系,不是 GPU 上已经测得的运行时间,也不能用它直接推出整个 kernel 会加速多少倍。
4. Padding 真正改变的是哪一条地址公式?
考虑按行存储的二维 float tile。数组列数为 W 时,位置 (row, col) 对应的元素偏移为 row × W + col。
当一个 warp 中的 lane t 固定 col、分别读取 row=t 时:
- W=32:偏移为
32t + col,所有 lane 的 bank 编号相同。 - W=33:偏移为
33t + col,bank 编号随 lane 改变。
因此,把二维 tile 的物理行跨度从 32 改成 33,能够改变按列访问时的 bank 分布。这是 padding 有效的具体原因。不能只说“补一个元素就能消除冲突”。
原笔记末尾的示例把一维 s[32] 改成 s[33],但仍然让线程访问 s[tid]。这些线程的访问地址没有因为数组尾部多了一个元素而改变,所以该例不能证明 padding 消除了冲突。若要保留它,应把它作为“padding 无效的对照”,再另写二维按列访问的实验。
5. 怎样从原理走向可验证的优化
先列出每条共享内存指令对应的线程地址,再检查实际指令宽度及 profiler 中的共享内存相关指标。只比较源代码数组长度,不足以判断硬件行为;指标名称也应以本机 GPU 和工具支持的内容为准。Nsight Compute Profiling Guide
对于自己的实验,我会保留原版与 padding 版,先验证输出相同,再比较运行时间、共享内存占用和实际访存指标。padding 还会增加共享内存容量,可能影响可驻留的线程块数量;局部冲突减少,并不自动等于总耗时下降。
6. 这次学习留下的判断顺序
遇到共享内存性能问题时,我会先确认是不是同一 warp 指令中的不同地址落到了同一 bank,再判断改布局能否改变这些地址。只有确认地址关系改变后,才进入性能测量。这样就能避免把“数组变大”“内存合并访问”“广播”和“消除 bank conflict”当作同一回事。
资料与记录说明
原始笔记:FlowUs 页面。本文将原来的重复问答按主题组织,保留仍待验证的问题。
文中的运行截图和手稿来自历史学习记录;本次整理没有重新运行这些实验,也没有新增实测加速结论。
地址表和 padding 推导限定于文中说明的简化模型。更宽指令及其他架构需要按实际访问重新分析。