MPI 编程实践:消息长度、通信顺序与排错
最初学习 MPI 时,我记录了大量报错、示例代码和 C++ 语法问答。回头整理后,真正贯穿这些记录的主线是:进程之间既不共享普通变量,也不能仅靠“看上去相同”的代码保证消息匹配。必须把消息的长度、通信对象、执行顺序和缓冲区生命周期分别说明白。
1. 一次通信需要明确哪些信息?
在阅读发送和接收代码时,我会把下面的信息放在一起检查:通信域、源或目标 rank、tag、数据类型、元素数量,以及缓冲区实际大小。
原笔记里的第一次消息截断问题,发生在接收侧用 strlen() 决定接收长度时。接收前,本地字符数组未必已经包含一个有效、以零结尾的字符串;因此它的 strlen() 既不能代表发送方将发来的消息长度,也可能越界读取。发送方发送字符串时是否包含结尾的零字符,也需要双方明确约定。
这里要区分三件事:发送方实际发送了多少元素、接收方声称可接收多少元素、接收方真正分配了多大空间。第二个数字不能超过第三个对应的容量,也不能小于本次需要接收的数据量。
2. 不知道长度时,先探测再接收
对于变长消息,可以先探测匹配消息,通过返回的状态查询大小,再准备缓冲区。MPI_Probe 检查消息,但不把数据接收进用户缓冲区。MPI 标准:Probe
原笔记记录了一个很具体的错误:把 MPI_Get_count 的函数返回值重新赋给用于保存消息长度的变量。函数返回值与第三个参数写入的计数不是同一个概念;应分别保存调用状态与得到的元素数。计数按传入的数据类型计量,不能不加区分地当作字节数。MPI 标准:Return Status
整理后的操作顺序是:
- 选择预期通信域、source 与 tag,并探测消息。
- 查询相应数据类型下的数量,检查是否得到有效计数。
- 按实际数量准备存储。
- 使用探测状态对应的 source、tag 接收同一条消息。
- 检查调用结果,并在使用字符串前保证字符串表示有效。
这是一条控制流程,尚不是经过本次测试的完整代码。若多个线程可能同时接收消息,还必须避免探测之后消息被另一条接收操作取走。
3. 环形通信:rank 正确仍然可能卡住
原笔记使用以下关系确定左右邻居:后继为 (rank + 1) % size,前驱为 (rank + size - 1) % size。它们解决的是“发给谁、从谁接收”,并未单独解决执行顺序。
如果每个进程都先做阻塞发送,再接收,不能因为小消息测试能跑通,就认为程序对所有消息规模都安全。可以使用有明确先后关系的配对协议,或根据任务采用 MPI_Sendrecv;MPI 标准专门说明了这类操作对链式、环形移位通信的用途。MPI 标准第 4 章:Send-Receive
对于采用非阻塞通信的版本,还要等请求完成后再复用相关缓冲区。发送完成允许发送方更新发送缓冲区,但不等价于接收方已经处理完消息。MPI 标准:Communication Completion
4. 随机游走项目:把问题拆成四层
原始 random_walk 记录混合了模型逻辑、消息传递、C++ 容器与可视化。整理时可以把每一步执行划分为四层:
| 层次 | 应检查的问题 |
|---|---|
| 状态更新 | 每个 walker 的位置和剩余步数是否按规则更新? |
| 所有权变化 | walker 何时离开本进程,进入哪个进程的域? |
| 消息交换 | 本轮输出数量、接收容量、结构体表示是否一致? |
| 全局结束 | 本地暂时没有 walker,是否真的意味着整个程序结束? |
“本地队列为空”只能描述某个时刻的局部状态,不能单独证明没有在途消息或其他进程仍有工作。原笔记关于工作顺序与终止条件的疑问应保留为需要继续验证的问题,而不能在整理稿中写成已解决。
通过 MPI_BYTE 发送结构体时,也不能把“能访问到一片连续内存”当作通用序列化协议。原始示例依赖的结构体布局、字段类型和运行环境应写清楚;含指针或容器内部状态的对象尤其需要重新设计数据表示。
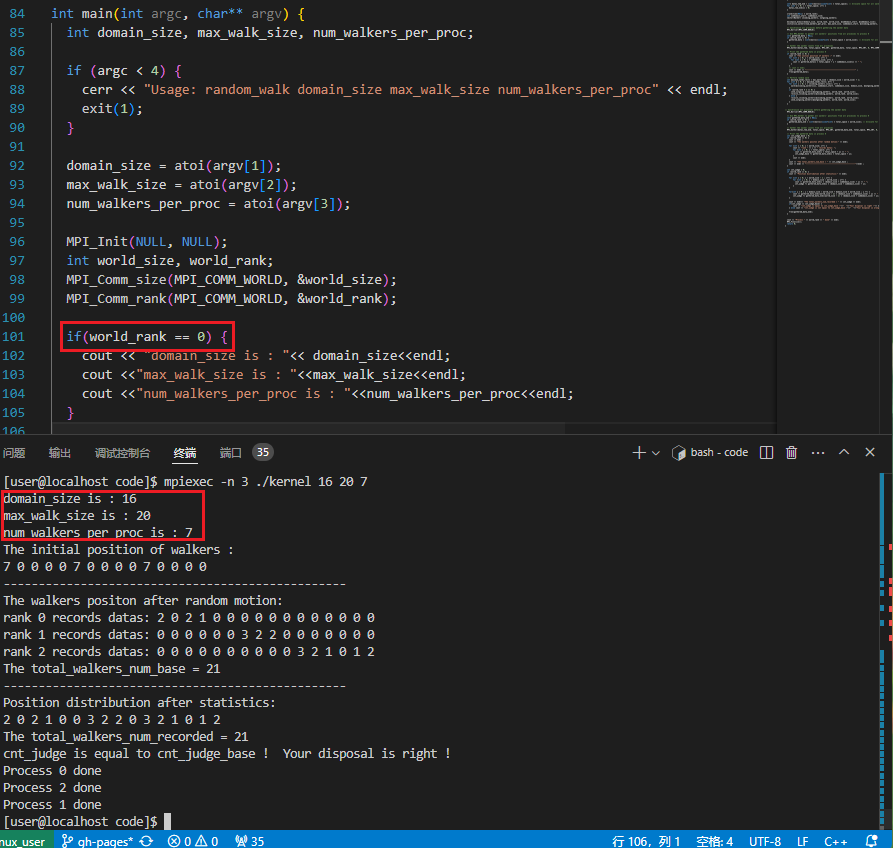
原笔记中标为理想输出的 rank 0 截图。
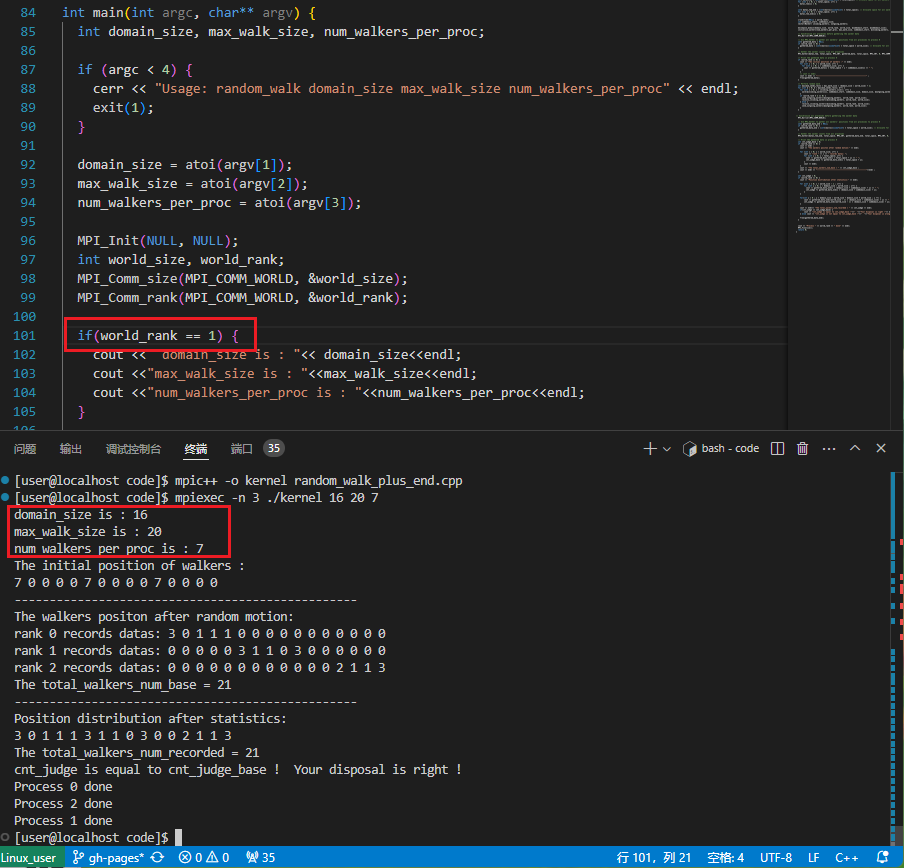
原笔记中标为理想输出的 rank 1 截图。
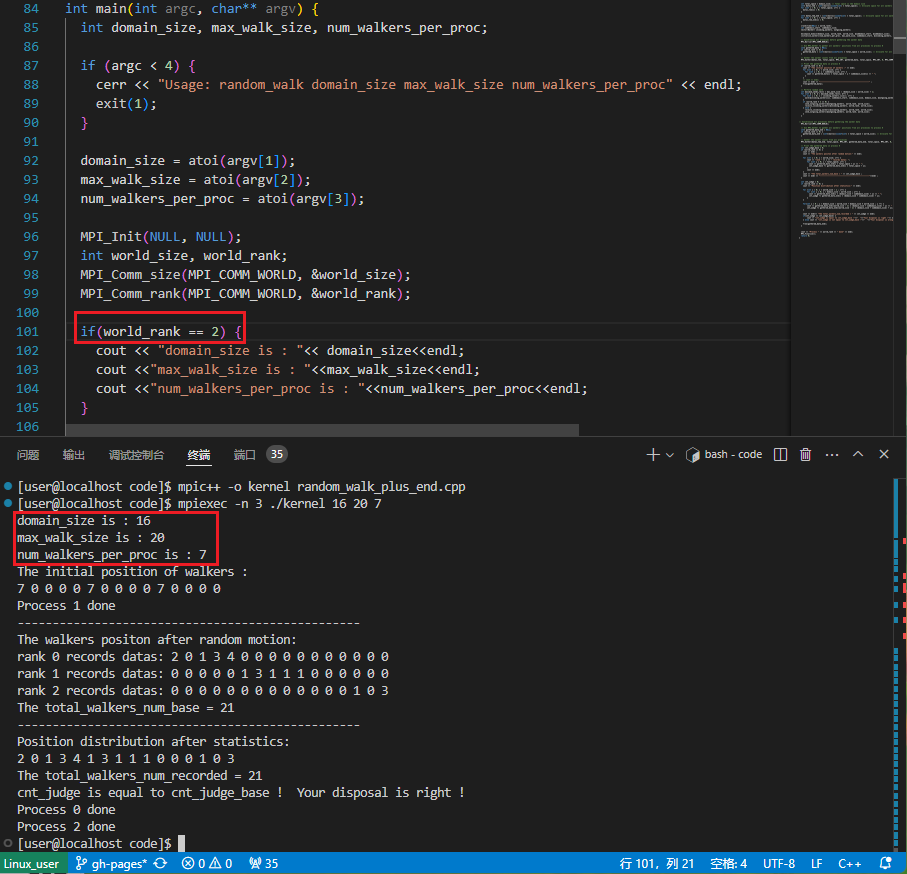
原笔记中标为理想输出的 rank 2 截图;原文虽提到 rank 3,但没有对应图片,不补造。
5. parallel_rank 与集体通信
parallel_rank 项目把输入汇总、全局排序与结果分发串起来,适合学习如何把串行计算组织成分布式步骤。阅读时,先用小规模手算每个 rank 应收到的结果,再检查集体通信的调用顺序、收发数量和边界。
排序存在相同值时,“名次”的定义也应先写清楚:究竟是稳定次序、共享名次,还是按索引打破平局。否则即便没有通信错误,也可能把算法定义差异误判成 MPI 问题。
原笔记开头已经意识到单次运行时间有波动。后续复现实验应固定进程数、数据规模与构建方式,先通过正确性检查,再重复测量。不要把某次 rank 的局部耗时直接当作整个程序的完成时间。
6. 偶发内存错误应如何保留证据?
原记录出现过 munmap_chunk(): invalid pointer 与 corrupted size vs. prev_size。这些现象值得保留,但不能从“连续运行后更容易出现”直接推断为 MPI 运行次数过多造成。
更有用的排查顺序是:固定能触发问题的小输入,核对接收容量、计数单位、容器大小与索引边界,再检查对象的生命周期。MPI_Finalize 附近出现堆错误,也不意味着破坏内存的操作发生在那里。
对于 vector,要把元素数量与已分配容量分开考虑。原笔记关于 push_back、clear、data 和扩容的解释,适合作为独立 C++ 附录,避免打断通信问题的主线。MPI 发送或接收仍在使用容器内存时,不能随意执行可能让地址失效的容器修改。
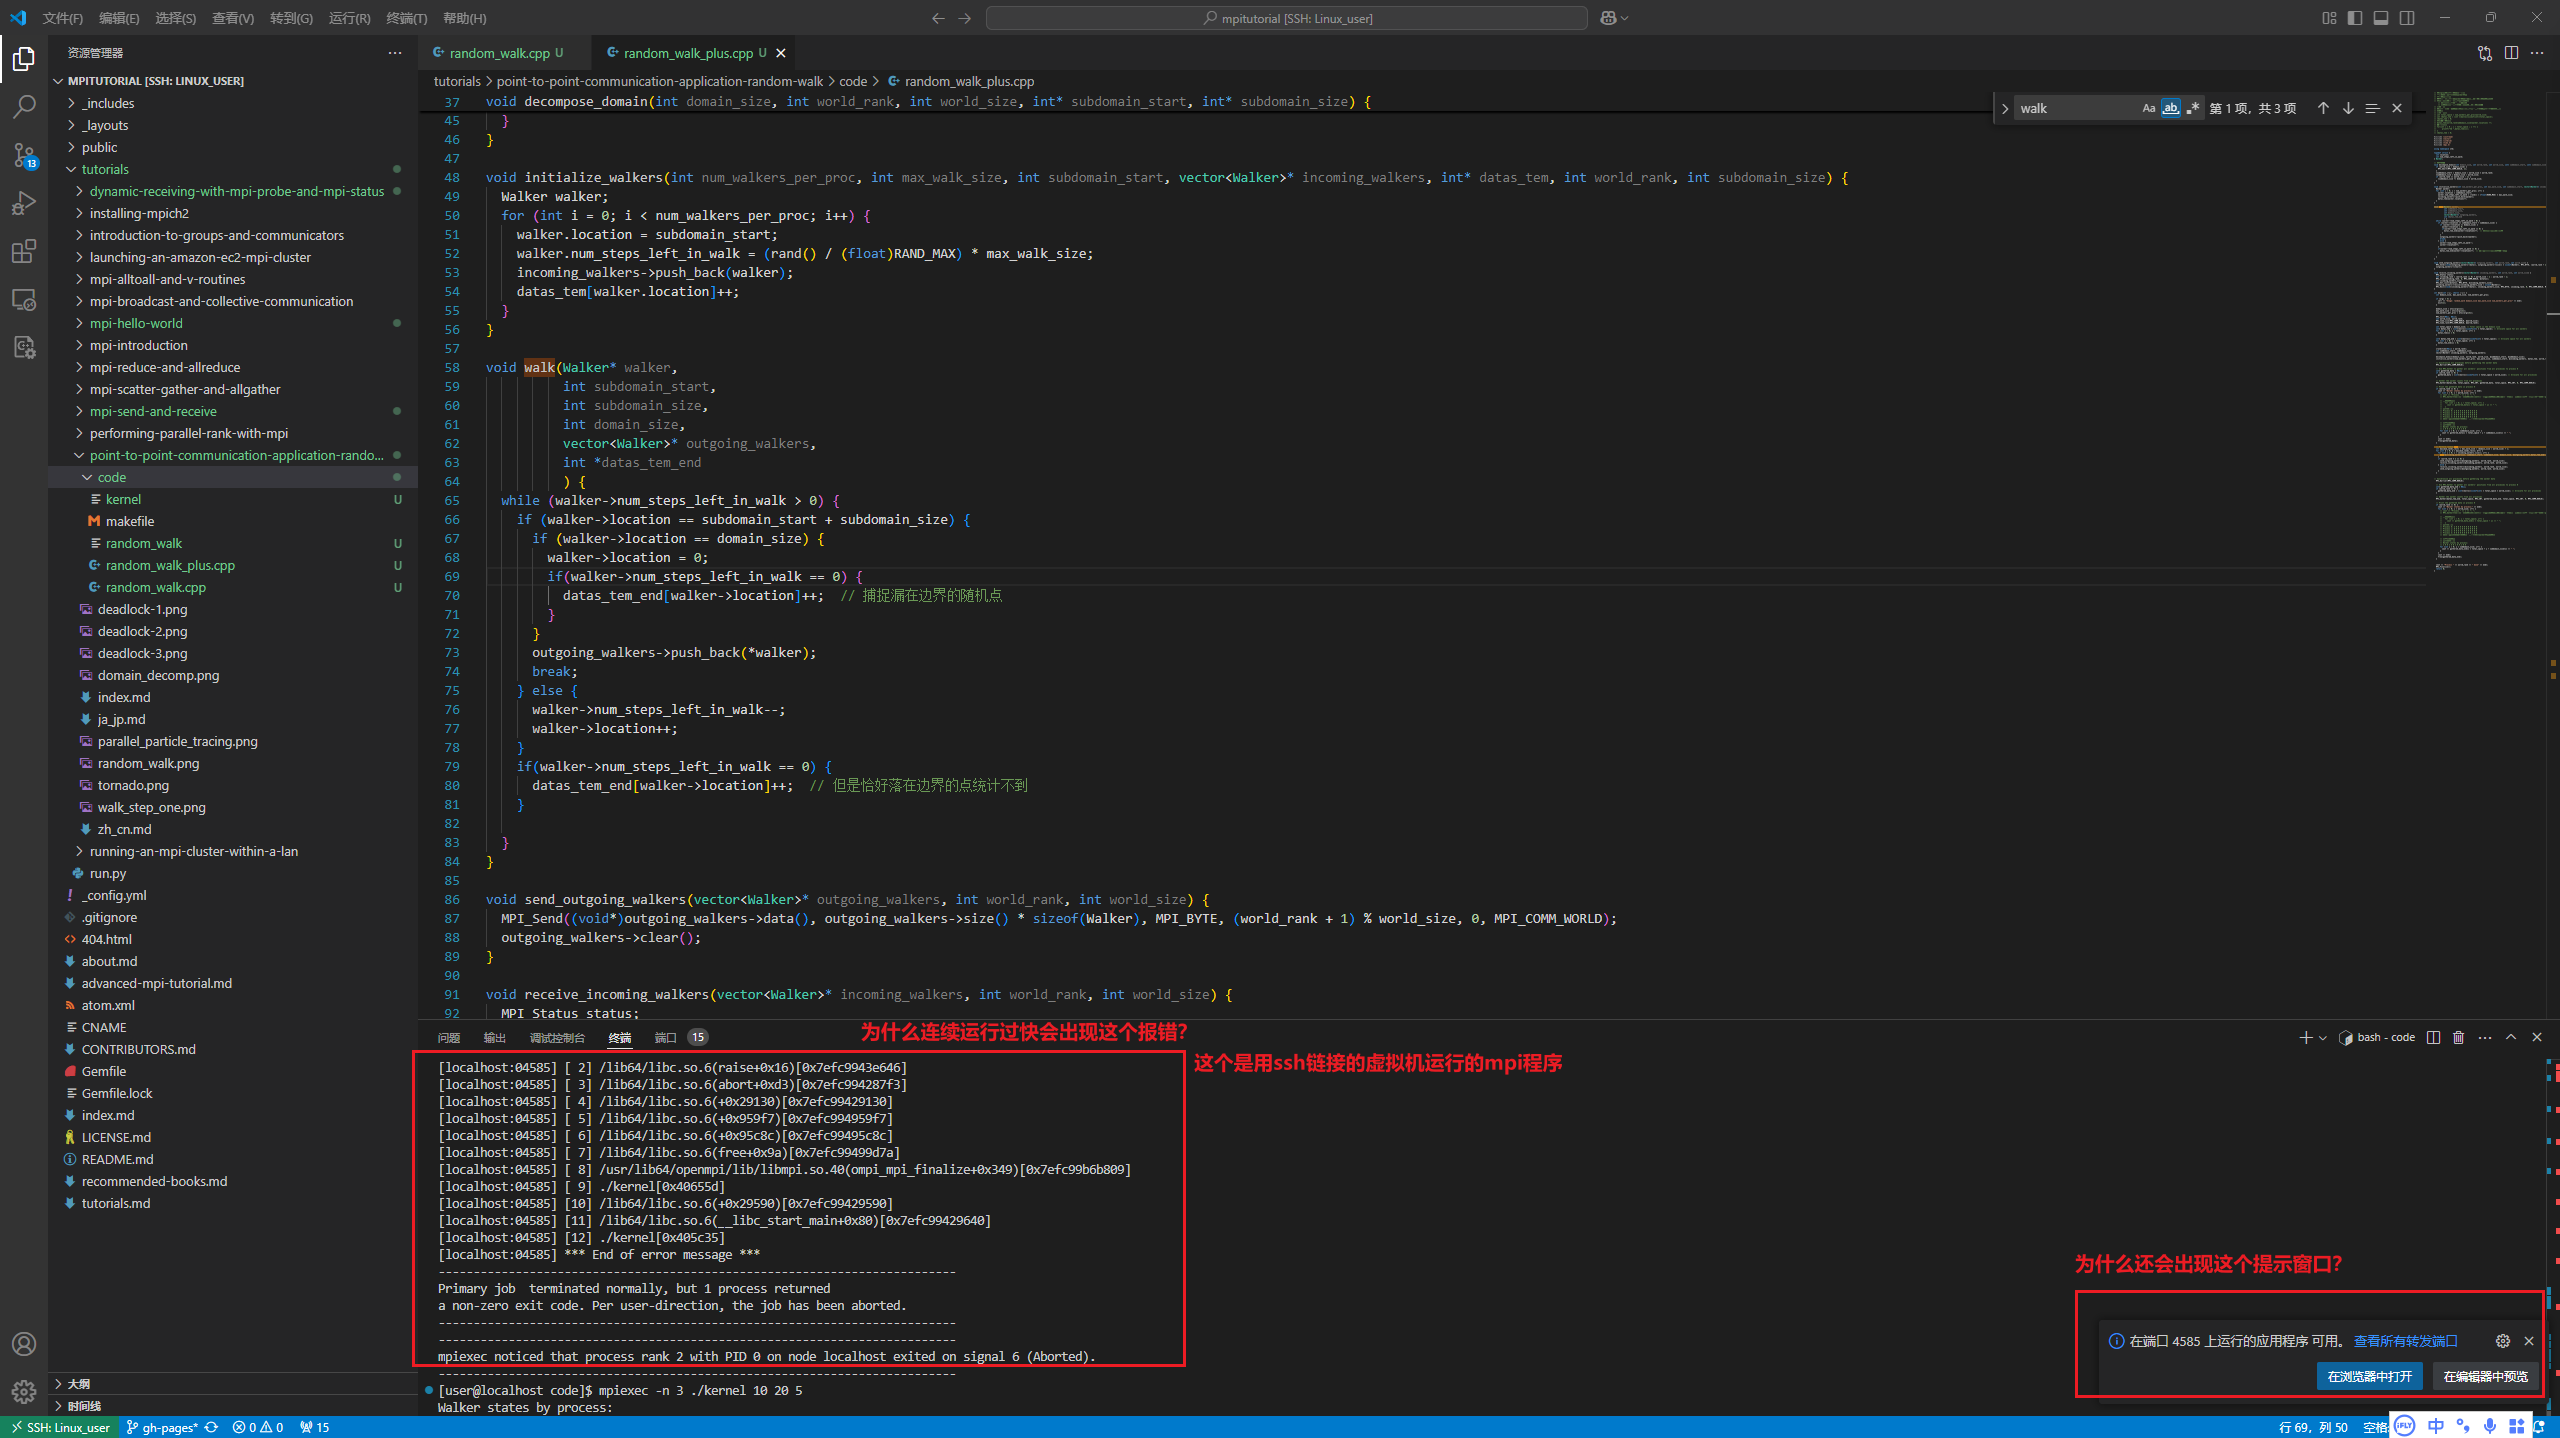
历史报错记录,用于说明问题现象;不作为根因已经确认或问题已经修复的证据。
7. 延伸学习
理解消息传递后,可以再单独整理 argv、vector 扩容、对象生命周期、模板与命名空间。它们影响程序的实现,但需要与消息协议本身分开分析。
资料与记录说明
原始笔记:FlowUs 页面。本文将原来的重复问答按主题组织,保留仍待验证的问题。
文中的运行截图和手稿来自历史学习记录;本次整理没有重新运行这些实验,也没有新增实测加速结论。