PANA:多核 CPU 上 SpMV 自适应负载均衡阅读笔记
论文核心思想与系统架构
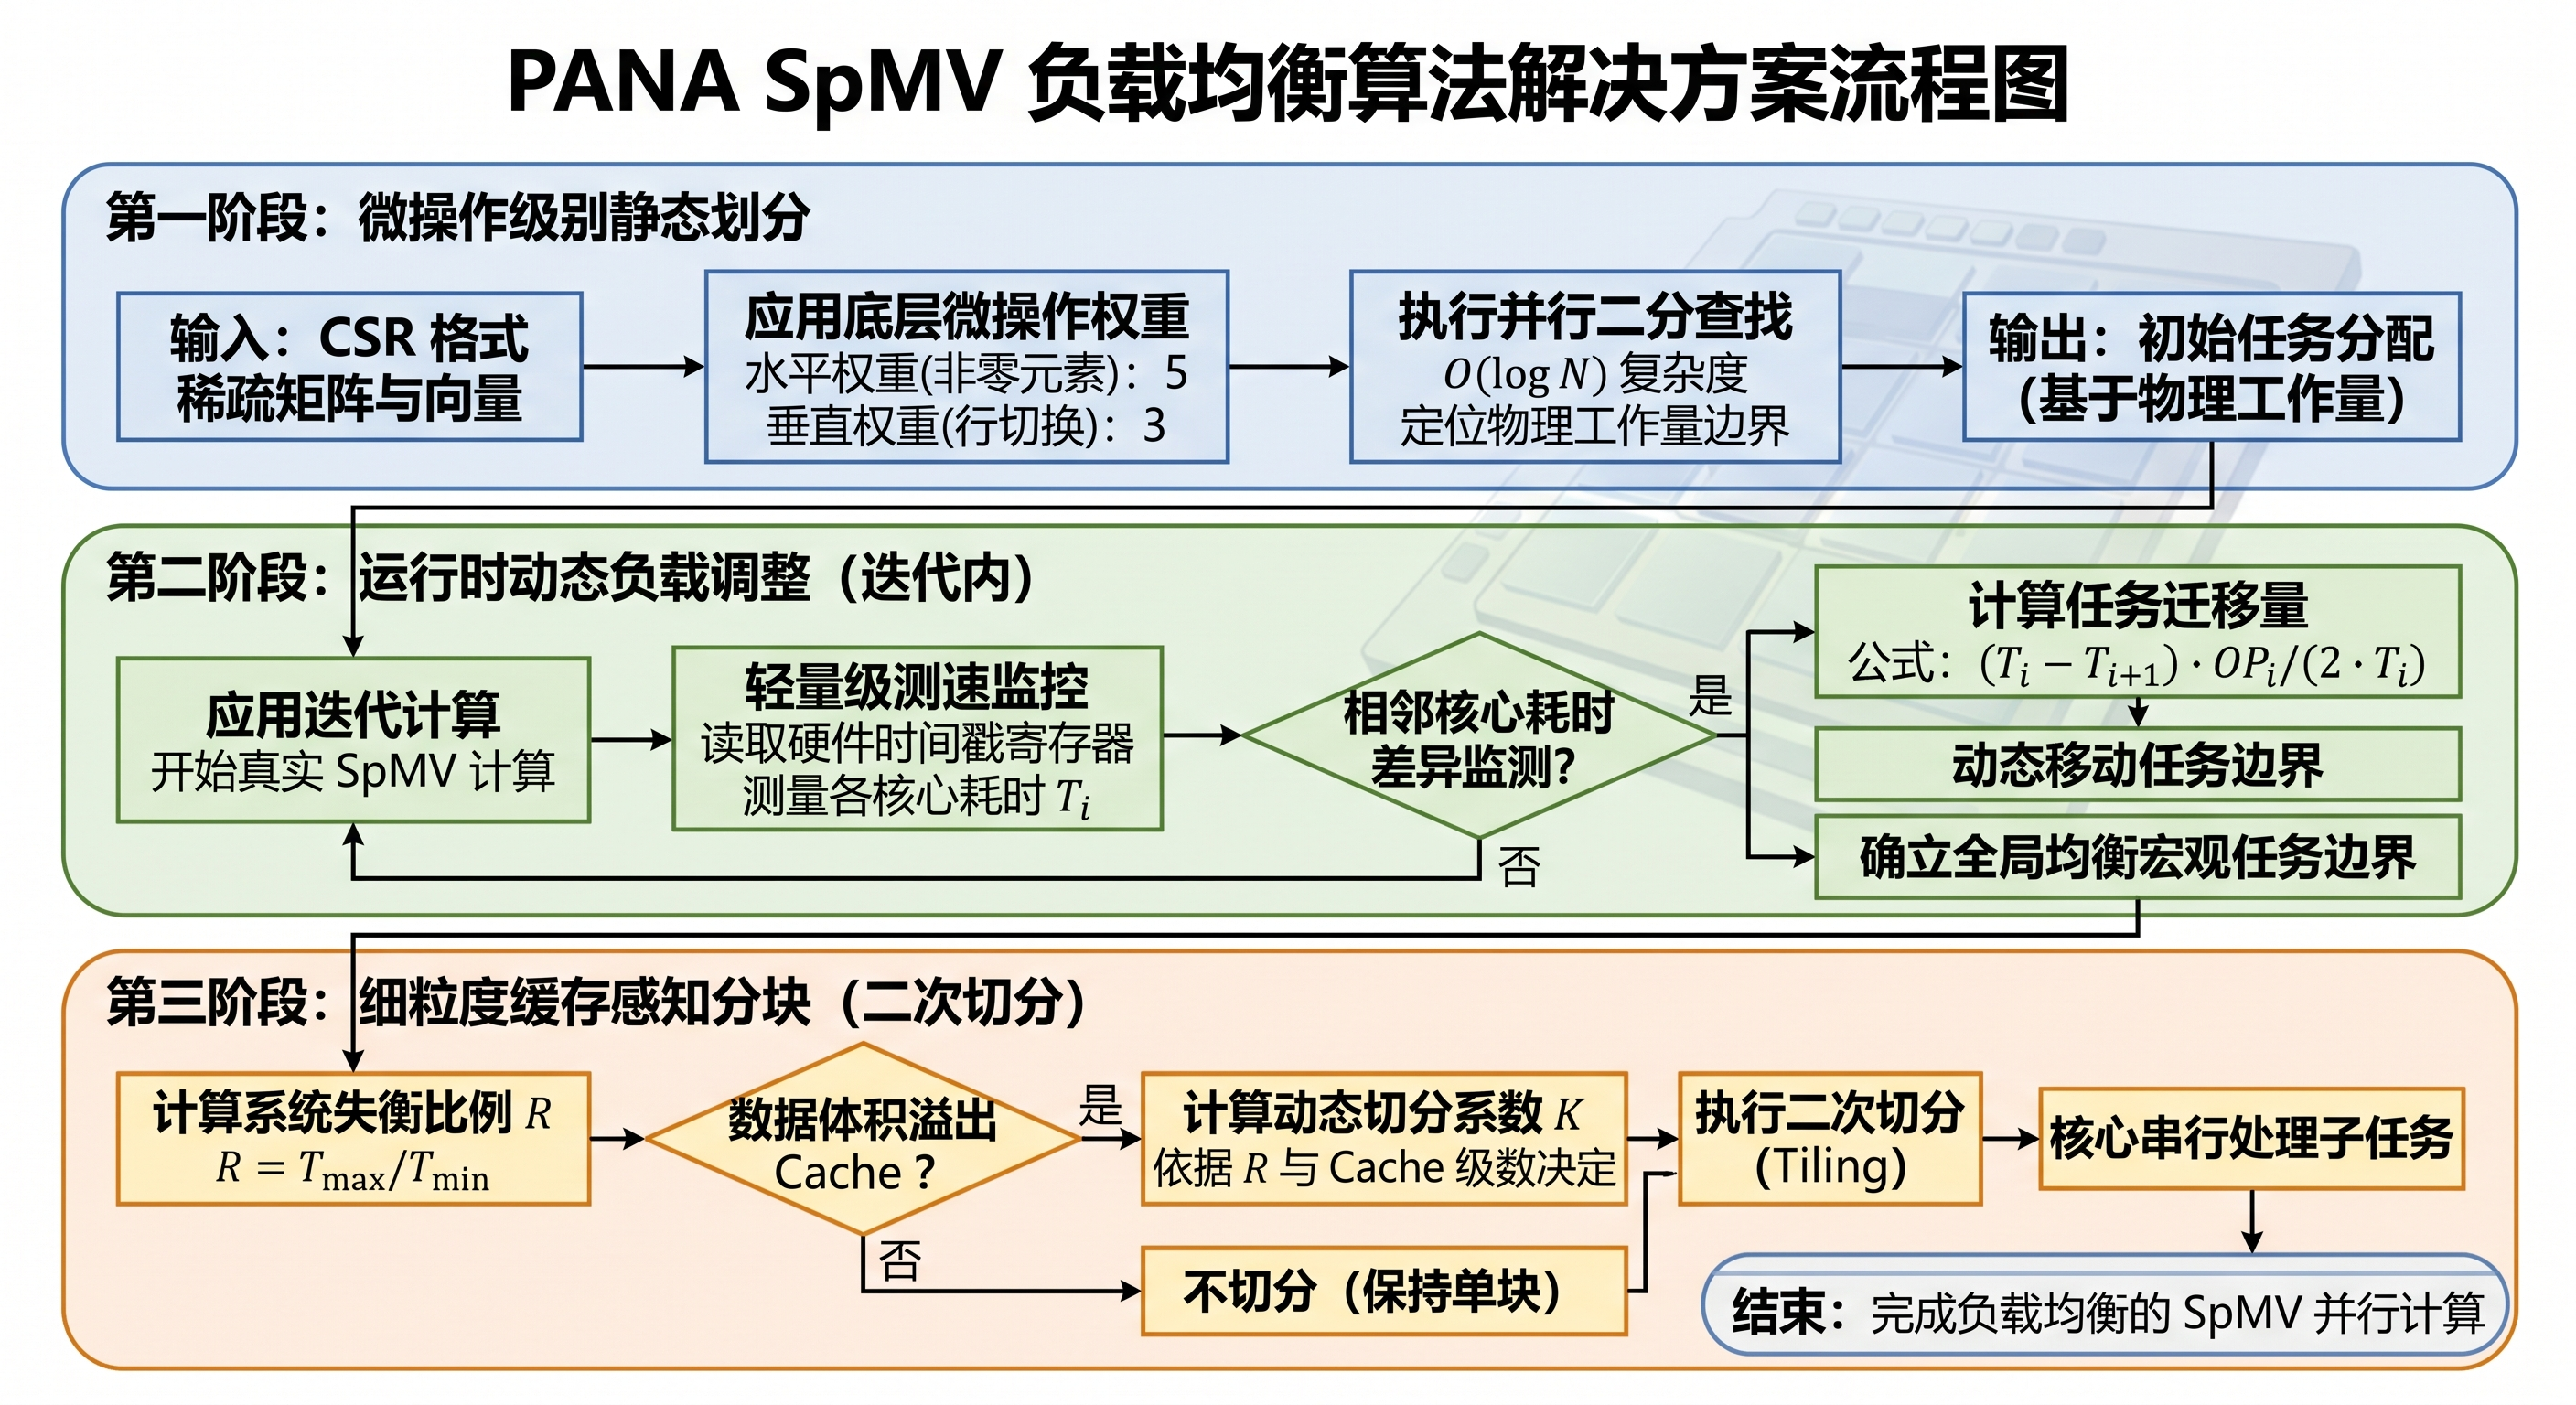
这篇论文探讨了多核处理器上稀疏矩阵-向量乘法(SpMV)的负载均衡问题。传统的静态划分策略通常仅关注计算量或访存量,难以适应不同矩阵结构与硬件架构的差异。为此,作者提出了一种细粒度、运行时自适应的负载均衡框架 PANA。该架构包含三个阶段:首先,将底层指令抽象为微操作(Micro-operation),分别为行切换与非零元素计算赋予垂直与水平权重,从而实现基于硬件执行动作的初始工作量分配。其次,在运行时监控各核心的执行时间,并根据时间差动态推拉相邻核心的任务边界,以应对硬件波动造成的执行效率差异。最后,结合缓存容量与运行时失衡比例进行细粒度二次切分(Tiling),在兼顾数据局部性的同时进一步均衡负载。
在工程实现与系统评估方面,PANA 在 Intel 与 AMD 平台上对 2,898 个真实稀疏矩阵进行了测试。结果表明,相较于 CAMLB、CSR5 等方法以及厂商数学库(MKL/AOCL),PANA 获得了稳定的性能提升。在工程设计上,为了控制预处理带来的系统开销,该算法放弃了复杂的矩阵格式转换,直接基于标准的 CSR 格式进行原位操作。同时,它采用 O(logN) 复杂度的二分查找进行任务定界,并将测速过程与实际的 SpMV 迭代计算重叠。这种设计将调度成本分摊到了大量的循环迭代中,保证了实际应用中的整体加速收益。
面向底层优化的科研启发
剖析这篇论文的架构思路,为底层并行算法的重构提供了客观的方法论参考:
软硬协同与微观视角: 在进行任务划分时,将视角从宏观的数据量(如非零元素个数)下沉至微观的硬件指令周期(微操作权重)。这种量化隐性开销的方法,能够更准确地反映真实的物理计算负载。
以动态调整应对硬件不确定性: 论文印证了在复杂的微架构(多级缓存、NUMA 拓扑)下,纯静态的负载分配存在固有的局限性。引入轻量级的运行时反馈机制,通过相邻节点间的局部边界微调来实现全局均衡,是一种具备较高鲁棒性的调度策略。
开销隐藏的工程思维: 在引入运行时监控机制时,避免执行额外的“空跑”测试,而是将探测逻辑嵌入到真实的应用迭代中。这种“边算边调”的工程权衡,为控制系统调度的附加开销提供了切实的参考方案。
Thinking Point
Q:为什么这篇论文的作者在解决这个行业问题(多核CPU上SpMV负载不均衡带来的性能损耗)的时候能够想到利用微操作切分与动态边界推拉的特点去解决,而其它学者没有想到?
A: 该论文作者能够利用底层微操作抽象与运行时轻量级自适应推拉机制解决 SpMV 的负载均衡问题,主要源于其跨维度(软硬协同)视角的应用、对底层硬件测量机制的极致把控以及问题抽象维度的转换。
传统高性能计算研究通常局限于宏观数据结构的重组(如发明极其复杂的 CSR5、CVR 等新矩阵格式),或过度依赖现成的重型系统层调度工具(如 OpenMP 动态调度),而作者打破了这一常规的技术路径依赖,将视角直接下沉至 CPU 硬件指令流水线层面,引入了“微操作(Micro-operation)”的权重打分机制来量化传统算法中被忽视的隐性物理开销。在此基础上,研究团队合理利用了极低开销的底层硬件时间戳寄存器(如 rdtsc)与