HierCut:分子动力学 16 位混合精度阅读笔记
论文核心思想与系统架构
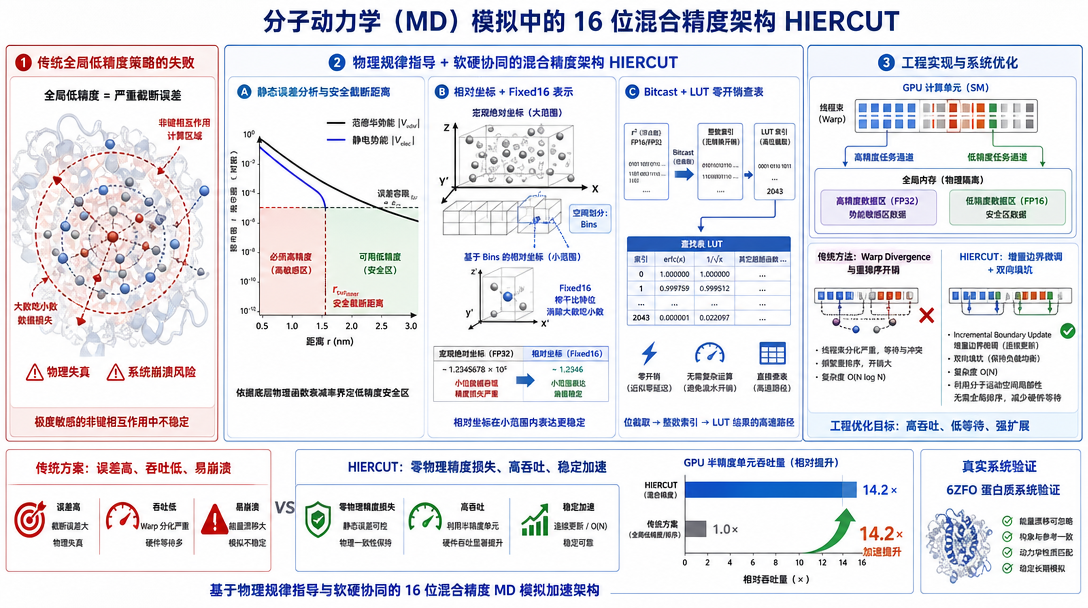
这篇论文探讨了分子动力学(MD)模拟中引入 16 位混合精度的精度与性能权衡问题。传统的全局低精度策略会导致严重的物理截断误差与系统崩溃,难以适应极度敏感的非键相互作用计算。为此,作者提出了一种基于物理规律指导与软硬协同的混合精度架构 HIERCUT。该架构包含三个核心机制:首先,通过基于底层物理函数衰减率的静态误差分析,精准界定安全使用低精度的空间截断距离(
在工程实现与系统评估方面,HIERCUT 成功在真实的复杂生物蛋白质系统(如 6ZFO)中验证了其有效性。结果表明,在保证物理模拟精度零损失的前提下,该方案大幅提升了底层硬件(如 GPU 半精度计算单元)的吞吐量。在工程设计上,为了控制混合精度带来的 GPU 线程束分化(Warp Divergence)与重排序开销,该算法放弃了传统的
面向底层优化的科研启发
剖析这篇论文的架构思路,为底层并行算法的重构提供了客观的方法论参考:
基于物理规律的数学解耦: 在进行精度降级时,跳出盲目试错的黑盒模式,将量化误差与底层物理公式的导数(变化率)严格绑定。这种从物理特性推导静态基准线的方法,使得混合精度的适用边界成为一道可精确求解的数学题,为系统级优化提供了绝对的安全底线。
数值解释域的相对性重构: 论文印证了在面临宏观极大值与微观极小值并存的跨尺度计算时,传统浮点数(科学计数法)存在固有的比特位浪费。引入空间网格划分,将绝对坐标转化为具有严格上限的相对偏移量,并采用定点数(Fixed Point)重新接管比特位预算,是一种极其有效的突破数值精度瓶颈的软设计思路。
顺应硬件逻辑的降维打击: 在处理复杂的数学超越函数与 GPU 线程分化时,避免在硬件弱项上死磕。通过“增量边界更新”将沉重的全局排序降维为极轻量的局部微调,以及利用“零开销位截取查表”将浮点硬算转化为纯整数访存,这种迎合底层芯片“有规律、无分支、纯整数”执行模式的工程思维,为榨干硬件算力提供了切实的参考方案。
Thinking Point
Q:为什么这篇论文的作者在解决这个行业问题(分子动力学模拟中引入16位低精度导致的精度崩塌与调度损耗)的时候能够想到利用物理误差分析、相对坐标以及增量重排的特点去解决,而其它学者没有想到?
A: 该论文作者能够利用静态误差分析、相对定点坐标与轻量级增量重排机制解决 MD 混合精度的落地问题,主要源于其跨学科(物理-数学-计算机系统)视角的深度融合、对底层数据比特位流转的极致剖析以及对性能瓶颈的重新定义。
传统的高性能计算研究通常局限于单一维度的优化:要么在算法层生搬硬套标准的低精度浮点格式(导致大数消去现象),要么在硬件层强行利用复杂的树状分支或全局排序来分离任务(导致灾难性的调度开销),而作者打破了这种常规路径,将视角上推至物理学的力学衰减规律,下沉至 GPU 寄存器的比特位(Bits)预算分配。在此基础上,研究团队合理利用了 MD 系统天然的空间局部性,将极具破坏性的大尺度绝对坐标“圈禁”在微观网格(Bins)内,使 Fixed16 定点数的高精度表达成为可能。此外,作者将混合精度带来的 GPU 调度灾难,从单一的“硬件线程等待问题”,重新抽象为“具有时间连续性的数据局部重排问题”,这就使得引入上一次边界作为基准的