Binary Compatible Critical Section Delegation 阅读笔记
论文摘要(主要内容以及核心机制)
本篇发表于 PPoPP 2026 的论文探讨了高性能计算中由于多核锁竞争引发的缓存颠簸问题。传统的委托(Delegation)机制虽然能通过将临界区集中到一个核心执行来减少缓存行的跨核移动,但往往需要开发者手动重构底层代码,或者面临未定义行为及程序崩溃等潜在的安全风险。为了解决这一可用性瓶颈,作者提出了一种名为 BCD(Binary Compatible Delegation)的二进制兼容委托框架。BCD 架构利用了操作系统内核的介入时机,当大量并发导致线程调用 futex_wait 与 futex_wake 陷入内核时,它会实施底层拦截。系统采用了基于整数位图(Bitmap)和缓存行对齐状态的无锁天鹅绒等待队列(Velvet Wait Queue)替代传统锁队列。释放锁的唤醒者通过竞争成为局部的“代理人”(Delegate),原子性地收集同一 NUMA 节点内所有排队线程的执行请求。随后,代理人借助 Userspace Bypass(UB)这一内核级虚拟机,在受限的安全沙盒内代为执行这些短小的临界区指令。这种设计有效消除了大量线程在内核中排队休眠所带来的上下文切换开销,同时使共享数据能够驻留在代理核心的缓存中。
在充分的系统实现下,BCD 展现出了显著的性能提升。通过工业级应用基准测试,该框架在无需修改用户态代码的前提下,使得 Memcached 的吞吐量提升了 97.44%,LevelDB 的吞吐量提升了 24.88%。然而,作为一种受操作系统内核限制的优化方案,BCD 也做出了相应的系统级妥协。由于无法干预用户态原生的快速路径(Fast Path),委托执行过程中的锁容易被新到达的线程获取,从而打断了批处理节奏,限制了加速的上限。此外,为了提升无锁入队效率,系统牺牲了 NUMA 节点内部线程调度的公平性,并且该机制依赖底层的 futex 系统调用,在面对纯用户态死循环自旋锁时存在监控盲区。
论文启示
剖析这篇系统论文的架构思路,为后续的并行计算演进与底层算法重构提供了客观的底层视角与参考:
跨界与发散性思考: 在思考问题的解决方案时,不应局限于特定领域固有的知识框架,可以进行发散性思考,借助其他领域的可指导性思想或成熟工具来搭建解决方案。正如这篇论文跳出传统的锁机制优化,借助操作系统领域的内核虚拟机(VM)技术,构建了一个具备较高可移植性的并行优化框架。
访存成本意识: 论文印证了在复杂的体系结构中,“移动数据的成本通常高于执行计算”这一原则。在处理密集的流体力学求解器或将关键算子向 GPU 架构进行移植时,应当避免让大量的异构计算单元通过全局内存的原子操作去互相竞争共享边界数据。相反,应当考虑设置局部代理线程,在高速的共享内存域内预先完成无锁的规约操作。
异步批处理的设计映射: BCD 采用异步批处理取代同步阻塞的思路,能够有效映射到集群级通信库的设计中。通过解耦底层的数据演化与节点间通信,让就绪的异步数据流优先被提取和处理,可以较好地隐藏系统级延迟。
底层数据结构的参考标准: 这种对无锁数据结构(如位图与对齐的缓存行)的充分运用,为日常的并行代码重构提供了参考。
Thinking Point
Q:为什么这篇论文的作者在解决这个行业问题的时候(临界区竞争访问带来的性能损耗)的时候能够想到利用OS内核虚拟机的特点去解决,而其它学者没有想到?
A:该论文作者能够利用操作系统内核虚拟机解决并行计算中的临界区竞争问题,主要源于其跨学科视角的应用、对底层技术进展的把握以及问题抽象维度的转换。
传统高性能计算研究通常局限于用户态并发算法或硬件架构层面的调整,而作者打破了这一常规框架,将操作系统与系统安全领域中用于隔离验证代码的沙盒技术引入并发控制中。在此时机上,研究团队合理利用了近期提出的 Userspace Bypass (UB) 底层技术,将这一内核态机制应用于解决原有的用户态锁竞争难题。此外,作者将传统委托机制中常发的指令执行错误,从单一的性能缺陷抽象为多线程环境下的执行权限与信任隔离问题,这就使得引入内核虚拟机作为安全监察者与代劳者成为系统设计上的合理推演。这种跨领域的知识迁移与对问题本质的重新定义,共同促成了该架构的设计思路。
附件
Binary Compatible Critical Section Delegation.pdf
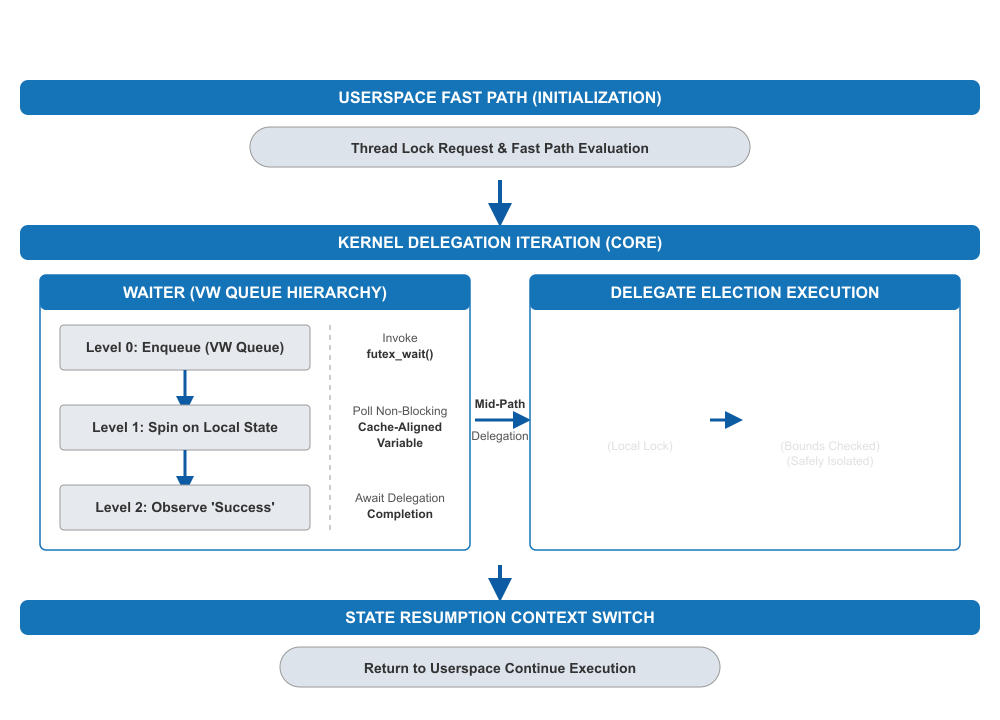
需要探究一下,该方案是如何实现“委托机制”的