Neural Collaborative Filtering 阅读与复现笔记
17-WWW-He-Neural Collaborative Filtering.pdf
前置知识
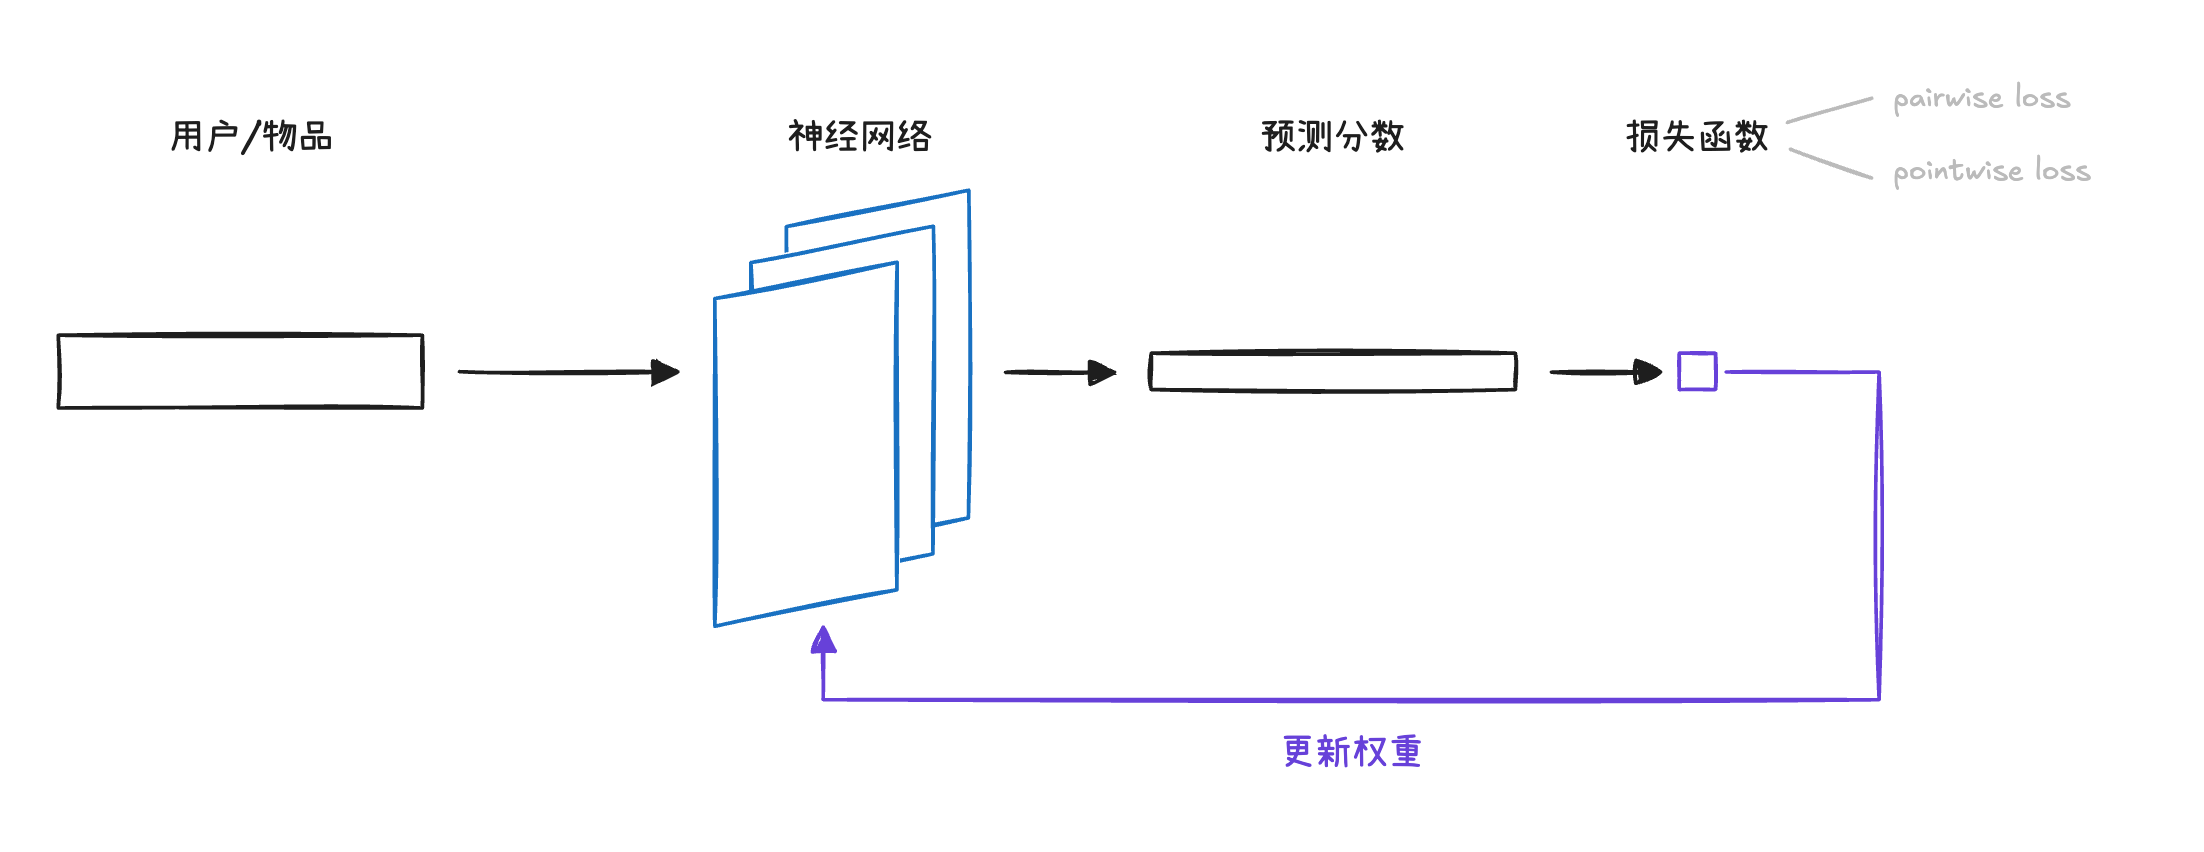
基于机器学习的推荐系统,其目标函数一般可以分为 pointwise loss(点式损失)和 pairwise loss(对偶式损失)。点式损失的训练方式主要是通过减小模型预测值和真实值之间的差异,从而使模型能够正确预测单个用户—物品交互;对偶式损失则不直接关注单个预测值是否准确,而是通过拉大正样本和负样本预测得分之间的差距,使正样本的预测得分高于负样本,从而得到符合预期排序关系的模型。
基于深度神经网络的推荐系统之所以能够兼容 pointwise 和 pairwise 两种训练方式,是因为神经网络本身主要负责学习用户和物品之间的交互函数,并输出预测得分,而 loss function 决定如何利用这些得分训练模型。Pointwise loss 直接比较单个预测得分与真实标签之间的差异;pairwise loss 则同时计算正、负样本的预测得分,并通过拉大二者之间的差距来优化排序。由于两种 loss 都可以通过反向传播计算梯度,因此可以在基本不改变神经网络预测结构的情况下采用不同的训练方式。
背景解析
传统的矩阵分解 MF 用用户隐向量和物品隐向量的内积来建模交互;本文提出 NCF 框架,把这种固定的内积交互换成可学习的神经网络交互函数,并在这个框架下给出了 GMF、MLP、NeuMF 三个实例。
“隐向量”这里的“隐”不是神经网络里“隐藏层”的那个“隐藏”,而是 latent 的意思,更准确的中文翻译其实是“潜在向量”或“潜向量”。由于用户到底喜欢什么类型、喜欢哪个演员、偏好冷门还是热门,这些并不是数据里直接给出的,而是模型假设每个用户和每个物品背后都有一组没有被直接观测到的特征,这组特征决定了它们是否会发生交互。因此我们把这些没有被直接观测、而是从行为数据中推断出来的特征,就叫做 隐特征
MF 下的推荐系统
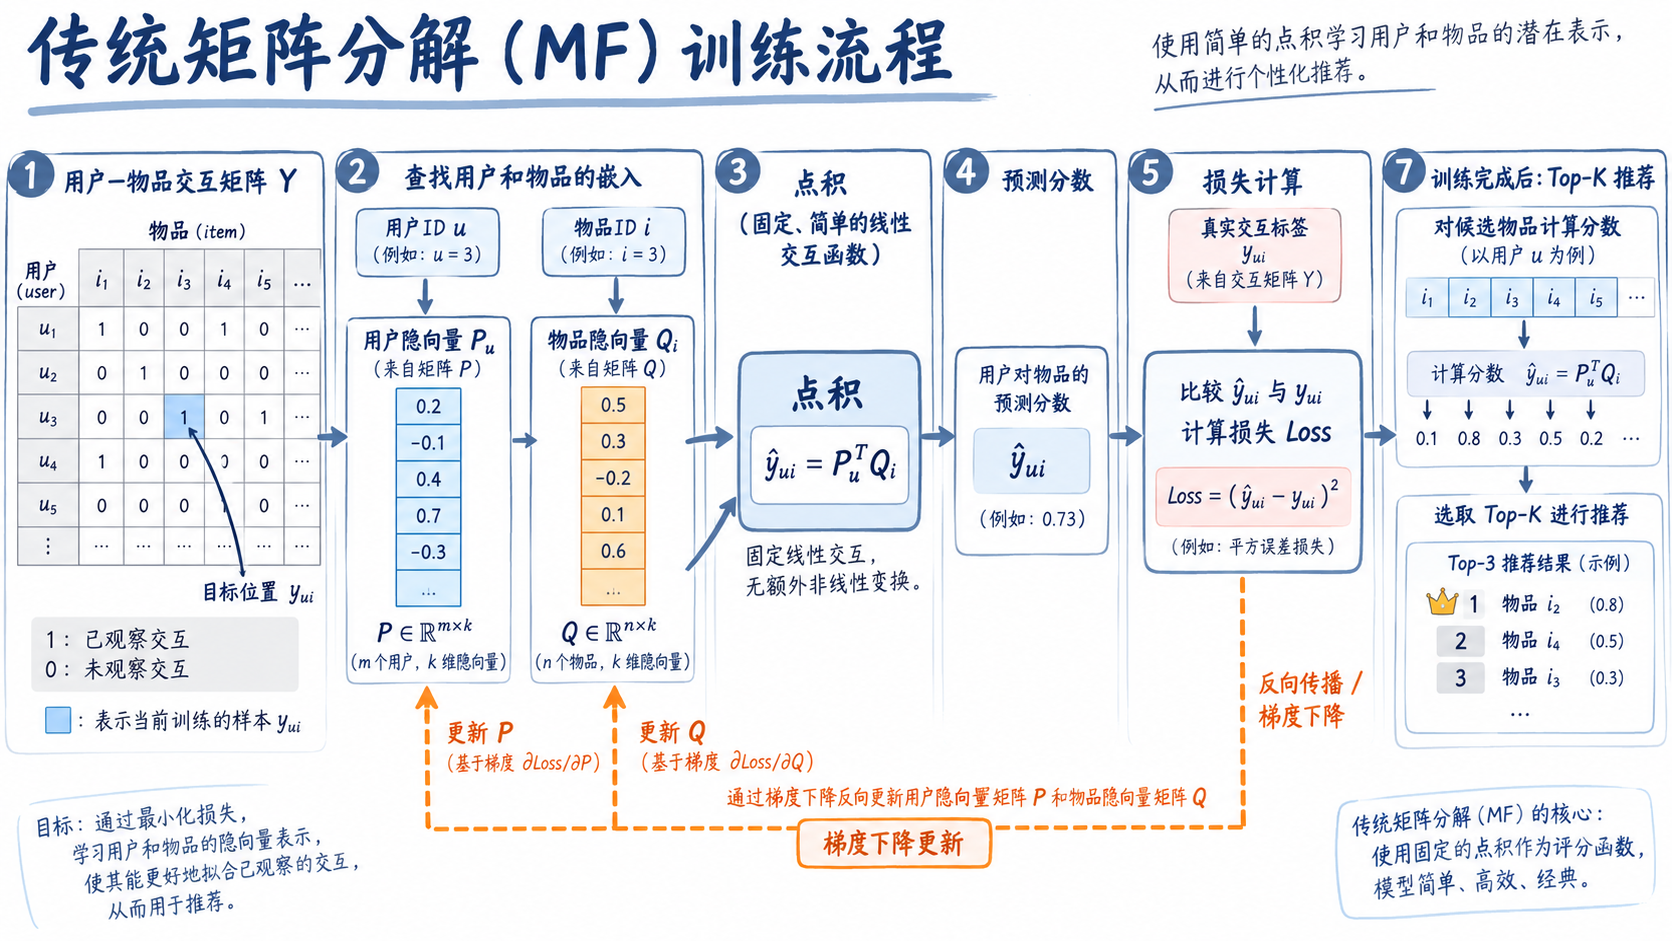
一句话总结:MF 从历史交互中学习用户隐向量 P 和物品隐向量 Q ,用二者点积作为匹配分数,再从候选物品中选择得分最高的 Top-K。
传统矩阵分解(MF)将用户—物品交互矩阵分解为两个低维矩阵:
通过二者内积预测用户对物品的偏好:
$\widehat{r}_{ui}=P_u^TQ_i $
训练时最小化预测值与真实交互的误差,学习
核心是:把用户和物品映射到同一个隐空间,用向量内积衡量匹配程度。
值得注意的是,由于用户每对一个物品进行交互都有可能改变用户的整体偏好,因此这种设计需要定时训练用户偏好向量
MF 存在的局限性
传统矩阵分解通过用户隐向量和物品隐向量的内积获得二者之间的交互得分。由于内积函数本质上只是将各个隐特征维度上的交互结果进行简单的线性组合,因此只能学习用户和物品之间较为简单的交互关系,难以表达更加复杂的非线性关系。此外,内积函数的表达能力有限,其对隐向量在向量空间中的几何关系具有较强约束,因此可能无法准确表示真实数据中更加复杂的相对关系和排序关系,从而造成排序准确性的损失。一种直接的解决方式是增加隐向量的维度,使模型能够利用更多 latent factors 表示用户和物品,但随着向量维度增加,模型复杂度也会提高,在数据较为稀疏的情况下更容易发生过拟合。
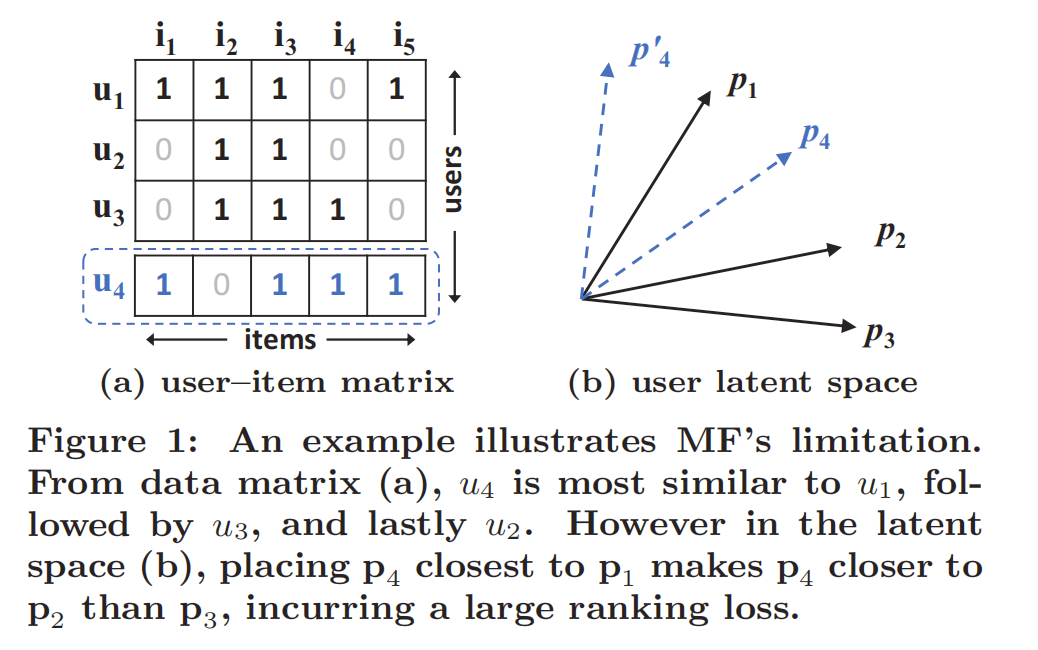
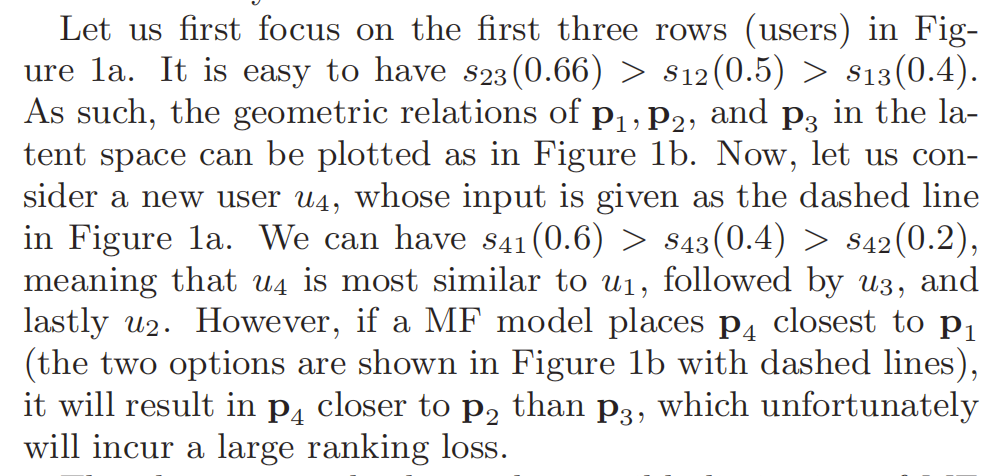
论文指出,MF 假设各个 latent factor 维度彼此独立,并对各维度上的乘积进行等权线性组合,因此可以看成一种 latent factors 上的线性模型。
论文中的 Figure 1 用了“向量之间的夹角/几何位置”来解释 MF 的局限,不过它明确加了一个前提:假设 latent vectors 是单位长度。(不要草率把内积公式对应向量间的夹角关系)
因此,与单纯增加隐向量维度相比,可以考虑直接提高交互函数本身的表达能力,例如使用神经网络学习用户和物品之间更加复杂的非线性交互关系。
NCF 下的推荐系统
My Thought:为什么论文要提出神经网络下的推荐系统?我认为是原本的MF模型由于其算法特点,只能学习到物品与用户之间线性的关系,无法提取非线性特征。而神经网络由于有非线性层的存在,能够让模型学习到元素之间的非线性特征,因此适合推荐系统。
传统矩阵分解(MF)通过学习用户隐向量与物品隐向量,并使用内积计算二者的匹配分数,具有结构简单、计算高效的优点。然而,内积是一种固定且相对简单的交互函数,它对用户偏好与物品特征之间的关系施加了较强的线性假设,难以表达更复杂的非线性交互模式。为突破这一限制,NCF 将传统 MF 中预先设定的内积运算替换为可学习的神经网络交互函数,利用多层网络和非线性激活增强模型的表达能力,使其能够从用户—物品交互数据中学习更灵活、更复杂的匹配关系。
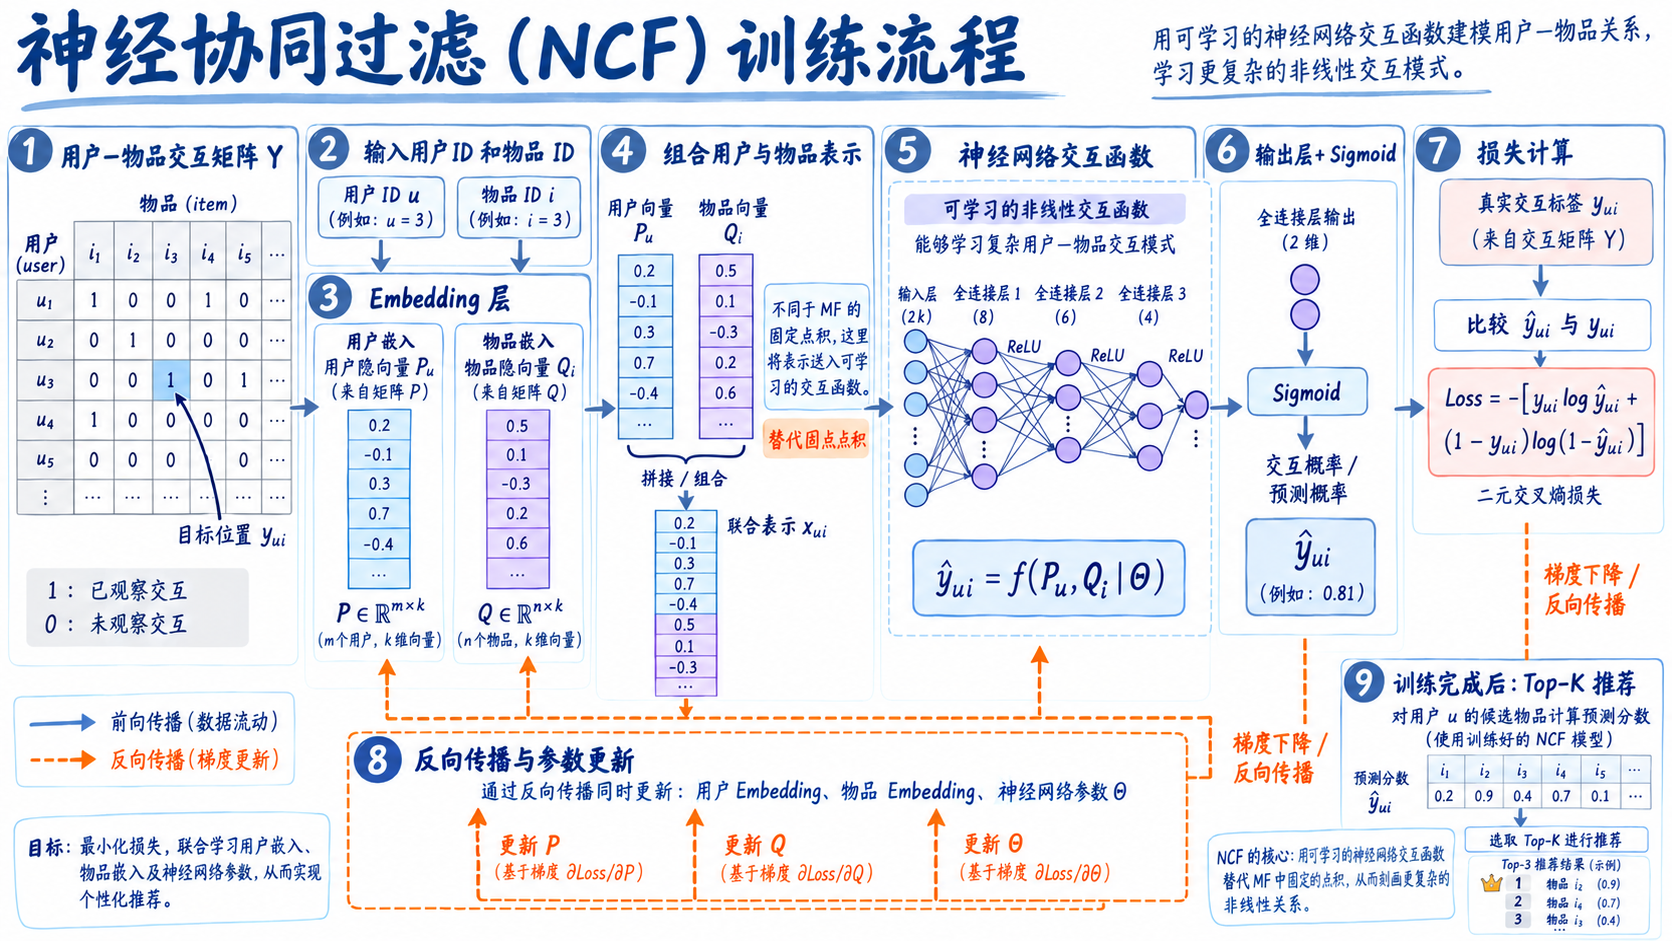
NCF 的通用框架
NCF 是一个通用的、基于神经网络的协同过滤框架,具体的 DNN 结构在这里就不再赘述,可以通过下面的 Figure 2 进行快速回顾。
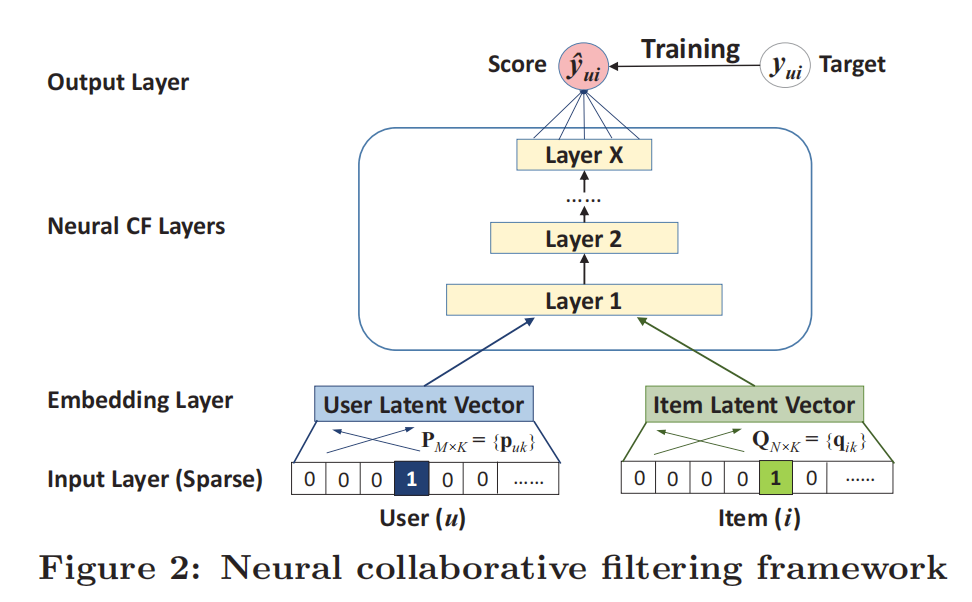
值得注意的是,论文中提到 NCF 中的各个 Neural CF Layer 都可以进行定制。这里的“定制”主要是指对各层的 mapping function 以及整体网络结构进行设计,例如选择不同的交互方式和激活函数,以及调整 DNN 的
layer_num、width等。整个 NCF 的 interaction function 则由这些 mapping function 共同组成。这里不要将其理解为每一层都对应一种能够被显式解释的用户—物品交互逻辑,各层实际学习到的仍然是 latent structures。
另外一个需要注意的是,二分类问题可以使用 MSE(论文中也进行了说明),但 BCE 的算法设计更适合二元隐式反馈的问题,因此对于 NCF 中这种 binary implicit feedback,作者认为 BCE / log loss 更合适。
GMF
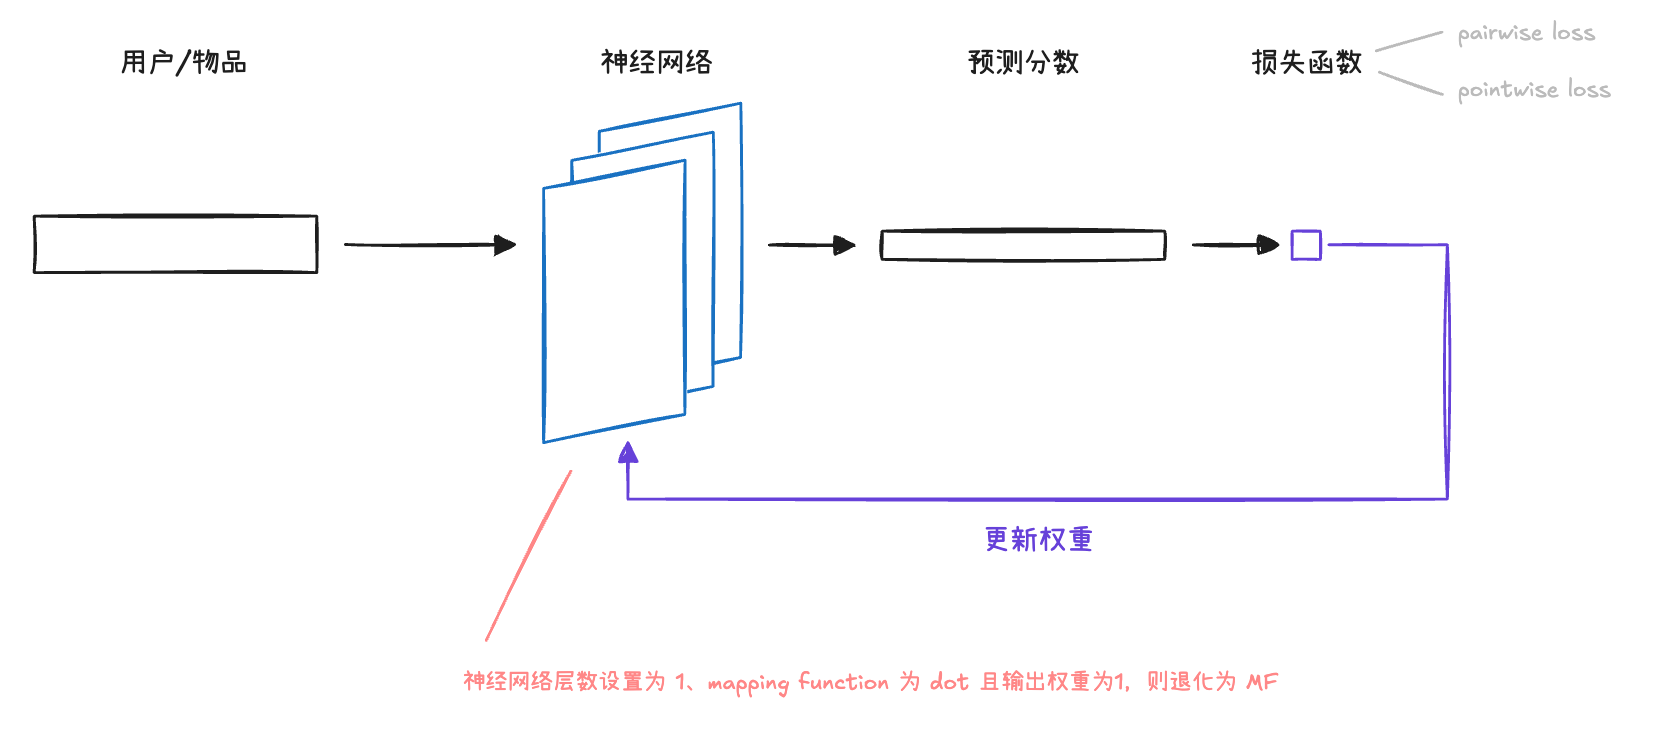
MF可以给解释为NCF(GMF)的一种特殊情况,即:
当 NCF 只使用一层 Neural CF Layer,并将该层的 mapping function 设置为用户、物品隐向量的 element-wise product,再通过可学习的输出层得到预测结果时,可以得到 GMF;如果进一步将输出层权重固定为全 1,并采用 identity activation,则 GMF 可以退化为传统 MF,也就是直接计算用户和物品隐向量的点积。
MLP
论文中是将用户向量和物品向量拼接在一起,随后通过MLP来学习用户-物品向量的信息
对于激活函数,作者比较了sigmoid、tanh 和 ReLU,认为 sigmoid 容易发生 saturation,tanh 虽然有所改善但仍有类似问题,因此最终选择 ReLU
网络宽度设计作者采用来了塔式结构,即越往上维度越少(halving the layer size for each successive higher layer),其目的是让MLP越靠后越能学习到更加抽象的特征
Fusion
GMF和MLP分别通过线性kernel和非线性kernel学习用户和物品之间的关系,我们可以尝试通过某种方法融合这两种方案各自的实现,从而更好模拟用户和物品之间的交互。
一种简单可行的解决方案是让GMF和MLP共用一个嵌入层,然后将它们交互函数的输出进行合并;另一种方式是让两种模型最后输出的向量维度数相同并连接最后的输出。
Issues
Q:反正都是向量经过MLP处理,为什么不把多轮训练,每次训练都是向量对合并在一起,直接通过向量矩阵实现单次多组合的训练呢?
可以这样训练
Q:为什么我三种模型重新进行训练的时候第一次训练出来的模型HR0的值都很高(0.9的样子)?
记错结果对应的训练日期了。
0.9的那几个模型是之前第一次验证模型训练通路是否存在问题时获得的结果。当时设置了评估样本数量为10,因此获得的HR和NDCG的值都较大
Pic
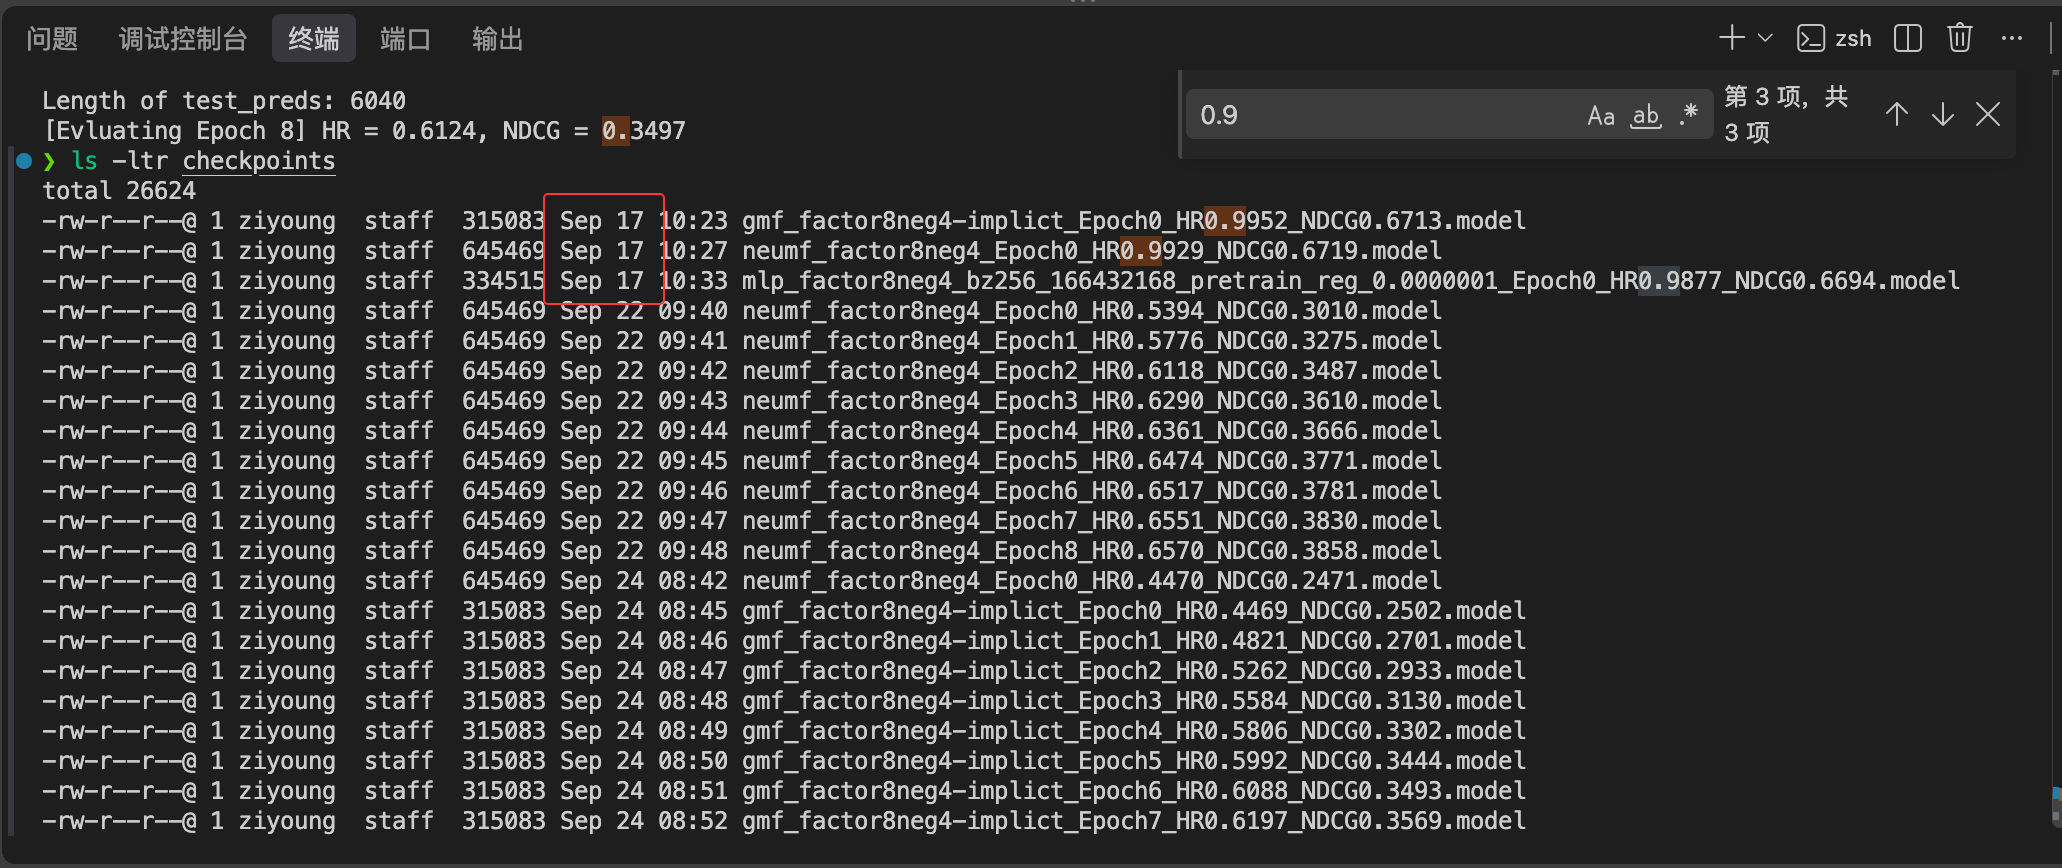
使用GMF和MLP的数据对NCF进行训练的时候记得修改优化器的参数
Q:为什么NeuMF直接训练200轮后损失值反而比预训练的要低(也就是拟合度更高)?
| epoch | scratch loss | scratch HR@10 | pretrain loss | pretrain HR@10 |
|---|---|---|---|---|
| 1 | 0.3596 | 0.7361 | 0.0173 | 0.7820 |
| 5 | 0.1831 | 0.8131 ← 峰值 | 0.0162 | 0.7787 |
| 50 | 0.0142 | 0.7656 | 0.0138 | 0.7738 |
| 200 | 0.0021 | 0.7311 | 0.0120 | 0.7705 |
两者使用的优化器不同。scratch 用 Adam,pretrain 用 SGD。Adam的修正步长更大, 因此更容易减少 loss ,同样也更容易导致过拟合。
对于NeuMF预训练路径,由于GMF和MLP预先经过训练,表达曲线已经成型,不需要快速迭代修正(导致过拟合),因此选用SGD进行微调
Q:为什么模型的预测准确度都是先增加,然后再降低?
模型发生了过拟合,这一点和论文的结论匹配
Others
负反馈:在这个语境下指的是没有被用户关注的项
推荐模型的训练方式分为Pointwise和Pairwise两类,分别对应将每个用户—物品对视为独立预测任务以及让已交互物品的分数高于未交互物品的训练方式
随机负采样就是从“该用户没有交互过的物品”里,随机抽一部分加入训练,并临时标成 0。否则训练集中几乎全是“交互过”的正样本 1,模型只会学到“所有输入都预测为喜欢”,无法区分哪些候选物品应排在后面。
但更准确地说,它不是防止“推荐候选只有交互过的物品”,而是给模型提供“相对不相关”的对照样本。推荐时,模型仍会给未交互物品打分并排序;负采样训练它把真正交互过的物品排得更靠前。
实验采用 leave-one-out 评估:
将每个用户最新的一次交互作为测试样本,其余交互用于训练;
测试时,将测试物品与随机抽取的未交互物品一起排序并使用 HR@10 和 NDCG@10 评价结果。