CS143 Study Record
题目集
编译器按照时间处理顺序可以分为:
01-01 Introduction
01-02 Structure of Cool
01-03 The Economy of PR
02-01 Cool Overview
02-02 Cool Example 0
02-03 Cool Example 1
03-01 Lexical Analysis 0
03-02 Lexical Analysis 1
03-03 Regula
03-04 Formal Language
03-05 Lexical Specific
04-01 Lexical Specific
04-02 Finite Automata
04-03 Regular Expression
04-04 NFA2DFA
04-05 Implement Fin
05-01 Introduction2?
05-02 Context Free Grammar
05-03
05-04
06-01
06-02
06-03
06-04
06-05
07-01
07-02
07-03
07-04
06-02 AST(Abstract Syntax Tree)抽象语法树
为什么要提出AST?
在编译器接收到输入字符流后,词法分析器(Lexer)会按照词法的规则(又被称为Pattern,通常用正则表达式、有限自动机等描述)扫描字符,跳过空白、注释等,识别出一个个词素 lexeme,并输出最终的 token 序列
Pattern(模式) 是词法规则的形式化描述,用来规定“某一类 token/lexeme 应该长什么样”。它通常用正则表达式表示,也可以由有限自动机实现。例如,标识符的 pattern 可以写成
letter (letter | digit)*,整数的 pattern 可以写成digit+,赋值号的 pattern 可以写成=。
lexeme(词素)是源程序中实际出现、并与某个 token 模式相匹配的字符序列,例如 position、=、60。词法分析器识别这些字符序列,并根据其类别生成相应的 token。
token(词法单元)是词法分析器输出的词法单元,表示 lexeme 的类别及附加信息,通常写成 <种别, 属性值>,例如 <id, "position">、<number, 60>、<assign, "=">。属性值可以为空;严格来说,标识符 token 的属性值常为指向符号表的指针,而不一定直接是字符串 "position"。
词法分析器用 pattern 去匹配输入字符流:如果一段字符与某个 pattern 匹配,这段字符就是一个 lexeme;而该 pattern 对应的类别及附加信息则形成 token。因此,pattern 描述“长什么样”,lexeme 是“实际匹配到的字符串”,token 是“归类后的结果”。
语法分析器接受上一步产生的 token 序列,并根据语言的语法规则(这里通常用上下文无关文法 CFG 描述,通常写成 BNF/EBNF 产生式)判断 token 序列是否合法,并把它组织成一棵 Parse Tree(分析树)。
Parse Tree 已经具备清晰的语法结构,理论上可以为后续的语义分析、类型检查、优化、代码生成提供基础。由于非终结符的层层推导,Parse Tree 中包含大量中间节点、单链推导等冗余信息,而后续阶段更关注抽象的语义结构,并不需要这些冗余信息。因此在实际编译器中,后续阶段通常不会直接基于 Parse Tree,而是会先转换成 AST
因此,编译器中引入了抽象语法树(AST)的概念:通过对 Parse Tree 进行抽象,去掉中间非终结符、分隔符、括号等具体语法细节,只保留赋值、二元运算、变量引用、常量、函数调用等有语义的构造,从而获得更加凝练的中间表示。AST 节点更少、结构更清晰,便于后续遍历、分析和变换,广泛应用于语义分析、类型检查、优化和代码生成等阶段。
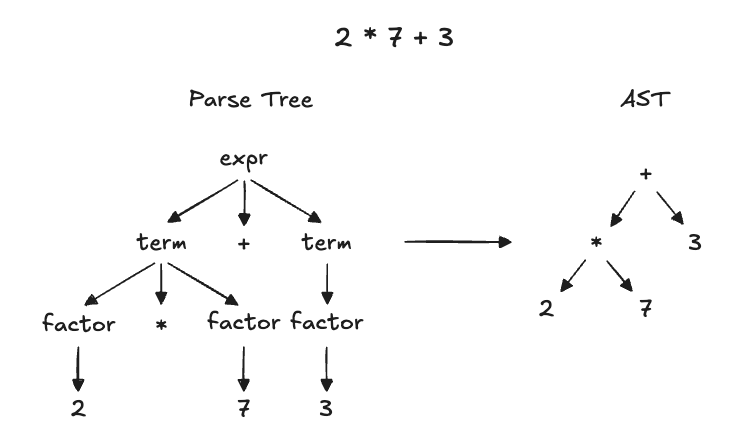
需要注意的是,AST 在概念上可以看成 Parse Tree 的简化版,但在实现上,编译器并不一定先构造出显式的 Parse Tree 再转成 AST。很多解析器会在语法分析过程中直接生成 AST,从而省去中间步骤,提高效率。
06-03 解析算法:递归向下解析-简易版本(Recursive Descent Parsing)
递归向下解析算法可以被看作是一种自顶向下的语法分析算法。它从文法的开始符号出发,自上而下、从左到右地为输入构造 Parse Tree。这里的输入通常不是原始字符流,而是词法分析器输出的 token 序列;算法会维护一个指向当前 token 的输入指针,也就是 lookahead。
对于给定的文法和输入 token 序列,递归向下解析通常为每个非终结符编写一个解析函数(子程序),这些函数通过相互调用来实现递归下降。函数根据当前 lookahead token,按照文法中该非终结符的产生式顺序,选择或尝试相应的产生式:如果产生式右部是终结符,就与当前 token 匹配并消耗它;如果是非终结符,就递归调用对应的解析函数。如此自上而下、从左到右推进,直到开始符号对应的函数成功返回,并且输入 token 全部消耗完毕。
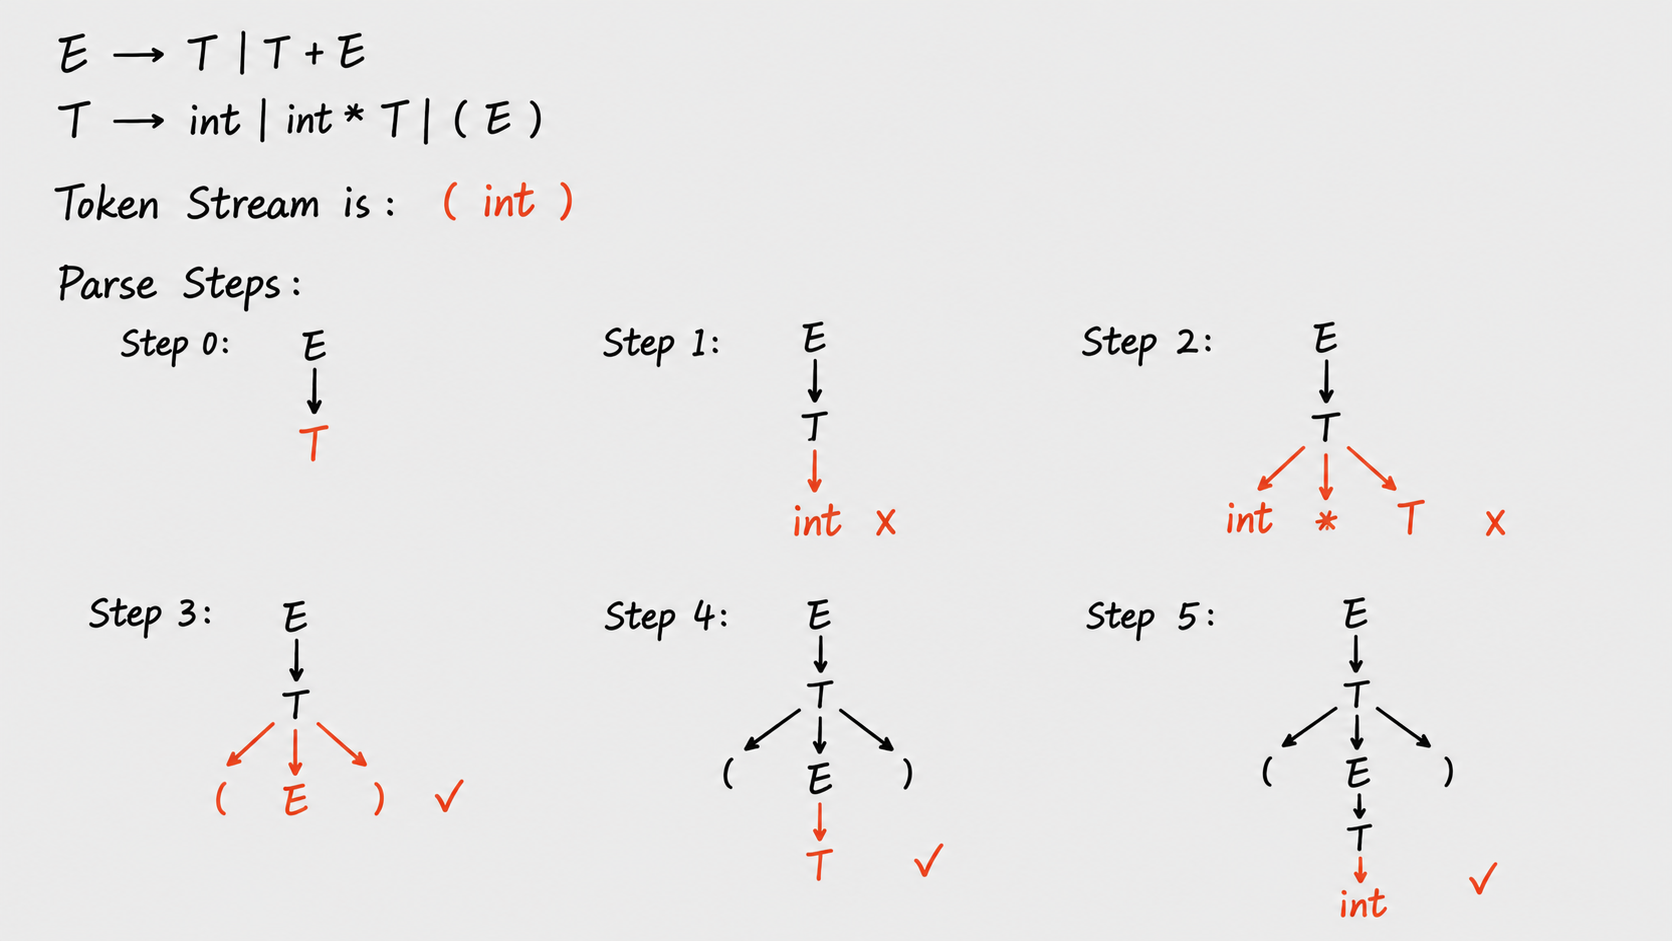
如果当前 token 与某条产生式不匹配,算法可能会回溯,去尝试该非终结符后面的候选产生式;这种带回溯的递归向下解析比较直观,但效率可能较低。预测递归下降则通过 FIRST/FOLLOW 集合等信息提前选择产生式,通常不需要回溯。若所有候选产生式都无法匹配,或遇到不该出现的 token,就说明输入存在语法错误,编译器会报告错误信息,并可能进行错误恢复,以便继续发现后续错误。
需要注意的是,递归向下解析通常要求文法不含左递归,并且尽量提取左公因子,否则可能导致无限递归或需要大量回溯。
递归下降解析算法-伪代码部分
对于递归下降算法(RD Algorithm)的伪代码,我们首先进行一些声明。
例如:
TOKEN 代表以下特殊的 token 类型:
INT、OPEN(左括号)、CLOSE(右括号)、PLUS、TIMES
next 是指向当前待匹配 token 的指针。
紧接着定义一组用于检查 token 是否属于目标类型的布尔函数。
对于已经给出的终结符 token 类型,判断当前 next 指针指向的 token 是否属于指定类型:
bool term(TOKEN tok) { return *next++ == tok; }这里无论匹配是否成功,指针都会向后移动一位。匹配成功返回 true,失败返回 false;指针的后移是后续回溯机制的一部分。
特定非终结符 S 的第 n 条产生式:
bool Sn() { … }特定非终结符 S 的所有产生式:
bool S() { … }对于上一节给出的文法和字符串序列,有:
非终结符 E 的产生式:
E → T:
bool E_1() { return T(); }E → T + E:
bool E_2() { return T() && term(PLUS) && E(); }E 的产生式函数:
bool E() {
    TOKEN *save = next;
    return (next = save, E_1())
        || (next = save, E_2());
}
非终结符 T 的产生式:
T → int * T:
bool T_1() { return term(INT) && term(TIMES) && T(); }T → int:
bool T_2() { return term(INT); }T → (E):
bool T_3() { return term(OPEN) && E() && term(CLOSE); }T 的产生式函数:
bool T() {
    TOKEN *save = next;
    return (next = save, T_1())
        || (next = save, T_2())
        || (next = save, T_3());
}
算法启动时,指针 next 指向第一个 token,同时调用 E() 函数。算法将会递归解析每个非终结符,并返回最终结果:若返回 true,说明输入 token 序列符合文法;若返回 false,说明存在语法错误。若要构造 Parse Tree 或 AST,还需要在匹配成功时增加构造节点的动作。
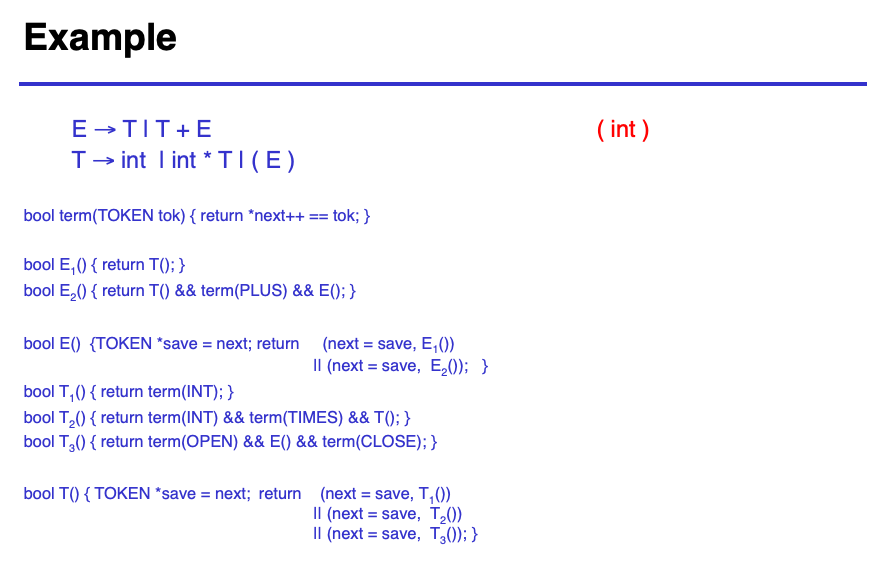
PS:通过伪代码我们可以很明显地看到一个问题:这个简易算法会按照产生式顺序依次尝试,一旦某条产生式匹配成功就立即返回,因此无法处理像
int * int这样虽然满足正确语法、但需要尝试更长产生式的 token 序列。比如在T()中,T → int排在T → int * T前面,导致int一旦匹配成功,后面的* T就被短路掉了,根本不会触发回溯。但显然,我们可以通过简单的 if 判断(或者更优雅的方式,比如调整产生式顺序、提取左公因子、使用预测分析)来解决这类问题。也就是说,实际上存在具有普适性的 RDA,只是为了教学方便,这里只给出了简易版本,方便我们理解(也方便我们 implement)。不过要注意,带回溯的递归下降虽然理论上能处理任意 CFG,但可能效率很低;实际编译器更常用预测递归下降,通过 FIRST/FOLLOW 集合提前选择产生式,从而避免大量回溯。
左递归问题(Left Recursion)
我们先看这样的一个例子:
对于生成式A:
由于向下递归算法是从左到右依次处理 non terminal 符,因此这个生成式中的 A 可以在不消耗 token 的情况下不断调用此生成式,导致无限递归。这就是在向下递归算法中需要避免的左递归问题。
左递归定义如下:
给定上下文无关文法
其中
从左递归产生条件来分析,消除左递归的方法大体分为两种。一种是改写文法,另一种是换解析算法。下面给出改写文法的例子。
改写文法
对形如:
A -> A α1 | A α2 | ... | A αm | β1 | β2 | ... | βn的直接左递归,可改写为:
A  -> β1 A' | β2 A' | ... | βn A'
A' -> α1 A' | α2 A' | ... | αm A' | ε
其中 ε 表示空串。
例如:
E -> E + T | T消除直接左递归后:
E  -> T E'
E' -> + T E' | ε
生成的语言不变,但不再左递归,递归下降可以正常处理。