CS143 Chapter 07
07-01 预测解析(Predictive Parsing)
我们可以从前面的小节看到,递归下降解析(带回溯的简易版本)是一种简单的暴力算法:它按产生式顺序依次尝试,失败就回退,对输入 token 序列进行解析。这种算法虽然理解和实现上都很简单,但时间复杂度可能非常大:
其中
观察递归下降解析算法可以发现,算法的时间主要消耗在产生式的不断匹配与回溯过程。多条产生式的 FIRST 集合重叠,导致解析器无法仅凭当前 token 唯一确定产生式,只能逐条尝试、失败回退,这是回溯产生的根本原因。左公因式是造成 FIRST 集合重叠的常见来源(但并非唯一来源)。
FIRST(α) 是从符号串 α 出发,能够推导出的所有可能的开头终结符的集合;如果 α 能推出空串 ε,那么 ε 也属于 FIRST(α)。换一种说法,我们可以把 FIRST 集合理解成:每条规则展开后,第一个终结符可能是什么。因此,如果同一个非终结符的多条产生式的 FIRST 集合出现重叠,那么构造解析表时,同一个单元格就可能被填入多条产生式,解析器便无法通过解析表确定唯一匹配的生成式。
为了解决时间复杂度过大的问题,我们可以把含有左公因式的产生式进行公因式提取和算式分离,并根据处理后的式子,结合非终结符的后续 token 建立 Parsing Table(预测分析表),为解析过程提供指导。建立 Parsing Table 和根据后续 token 选择产生式,可以看作一个预测的过程,因此这个算法被称为预测解析算法。应用上述方案后,算法时间复杂度显著下降至 O(n)。下面是一个具体的案例。
对于下列生成式:
E → T + E | T
T → int | int * T | ( E )
提取左公因式并重写为:
E → T X
X → + E | ε
T → int Y | ( E )
Y → * T | ε
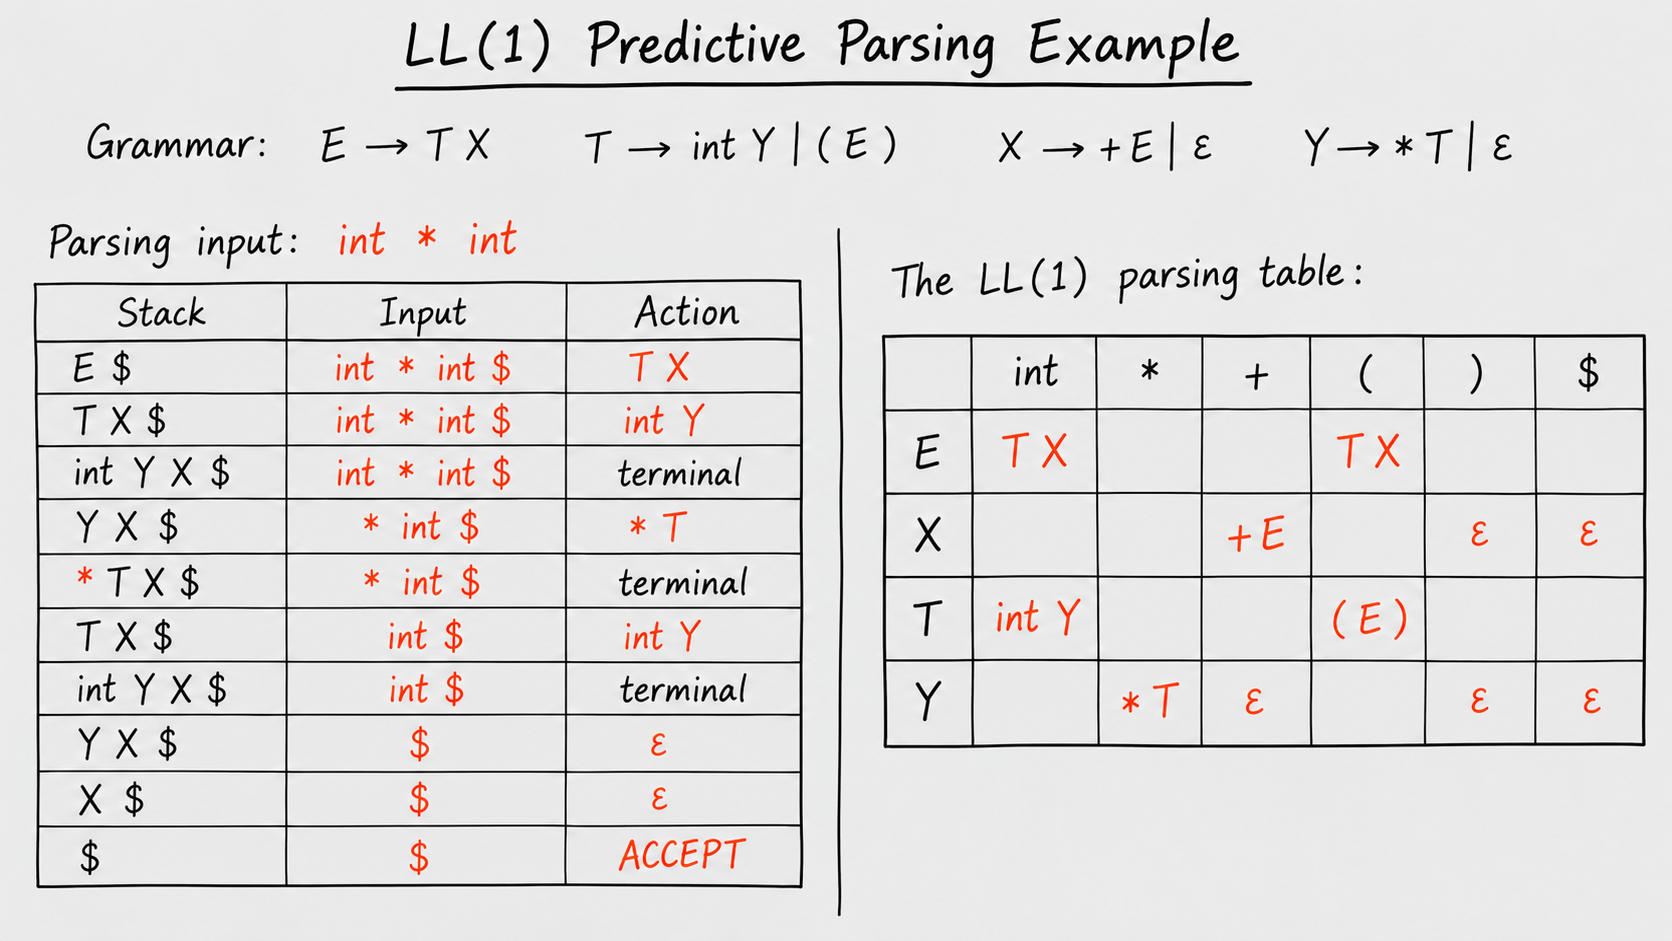
设置预测 token 数为1,根据重写后的生成式得到 Parsing tabel:
| int | * | + | ( | ) | $ | |
|---|---|---|---|---|---|---|
| E | TX | TX | ||||
| X | +E | ε | ε | |||
| T | int Y | (E) | ||||
| Y | *Y | ε | ε | ε |
完成以上预处理后,我们就可以根据预测解析算法解析 token 序列了。
预测解析算法和带回溯的递归下降不同:对于当前的非终结符,算法会查看后续 k 个 token(这里以 k=1 的 LL(1) 算法为例),根据 Parsing Table 的信息选择对应的产生式,而不是逐条尝试、失败回退。此外,算法会维护一个栈空间,将还没有处理的符号放入栈中。栈空间中主要包含以下元素:
还没有被展开的非终结符:会根据自身和后续 token 的类型查表,展开为对应的产生式右部;
还没有与输入匹配的终结符:与输入匹配后会被弹出栈。若无匹配的输入,则返回 error。
LL(1) 指根据当前一个 token 就能唯一确定使用哪条产生式的预测解析文法。其中第一个 L是 Left-to-right的首字缩写,表示从左到右扫描输入 token;第二个 L是 Leftmost derivation 的首字缩写,表示按最左推导展开。
initialize stack = <S $> and next
repeat
   case stack of
     <X, rest> : if T[X,*next] = Y1…Yn
                 then stack ← <Y1…Yn, rest>;
                 else error ();

     <t, rest> : if t == *next ++
                  then stack ← <rest>;
                  else error ();
until stack == < >
$ 为栈底的标识字符
下面是一个具体的实例
07-02 First Sets & Follow Sets
在上一节的内容中,我们知道可以通过分析表,根据当前的非终结符和输入符号,判断接下来应该使用哪个生成式进行解析。本节就要探究生成分析表之前需要准备的 First Sets & Follow Sets。
First Sets 可以直观理解为:从 α 出发,能够推导出的所有字符串中,第一个终结符可能是什么。需要注意的是,如果 α 能推出空串 ε,那么 ε 也属于 FIRST(α)。
First Sets 的定义为:
其中 α 为任意文法符号串,N 是非终结符集合,T 是终结符集合。
Follow Sets 与 First Sets 有一定联系,可以直观理解为:在文法的任意句型中,可能紧跟在非终结符 A 后面的终结符有哪些。如果 A 可能出现在句型末尾,那么输入结束符 $ 也属于 FOLLOW(A)。
Follow Sets 的定义为:
其中 S 是文法开始符号,$ 是输入结束标记。
需要注意的是,FOLLOW 集通常只对非终结符定义。
First Sets 和 Follow Sets 具有一些常用的计算规律。
对于 First Sets:
如果存在:
那么从左向右依次考虑每个符号的 FIRST 集。如果前面的符号都可以推出 ε,就继续考虑下一个符号;如果所有符号都可以推出 ε,那么:
对于 Follow Sets:
如果存在:
那么:
如果:
或者 A 本身位于生成式末尾,那么:
如果 S 是开始符号,那么:
这些定律看上去有些复杂,实际计算时只需要根据生成式不断向对应集合中加入元素,直到所有集合都不再发生变化即可。
还是以之前的文法举例:
E → T X
X → + E | ε
T → int Y | ( E )
Y → * T | ε
计算 First Sets:
T → int Y | ( E )
所以:
FIRST(T) = { int, ( }

E → T X
T 不能推出 ε
所以:
FIRST(E) = FIRST(T) = { int, ( }

X → + E | ε
所以:
FIRST(X) = { +, ε }

Y → * T | ε
所以:
FIRST(Y) = { *, ε }
最终:
FIRST(E) = { int, ( }
FIRST(T) = { int, ( }
FIRST(X) = { +, ε }
FIRST(Y) = { *, ε }
接下来计算 Follow Sets:
E 是开始符号
所以:
$ ∈ FOLLOW(E)

T → ( E )
所以:
) ∈ FOLLOW(E)

因此:
FOLLOW(E) = { $, ) }
继续看:
E → T X

FIRST(X) = { +, ε }

所以:
+ ∈ FOLLOW(T)

同时 X 可以推出 ε
所以:
FOLLOW(E) ⊆ FOLLOW(T)

得到:
FOLLOW(T) = { +, $, ) }
对于 X:
E → T X

X 位于生成式末尾
所以:
FOLLOW(E) ⊆ FOLLOW(X)

得到:
FOLLOW(X) = { $, ) }
对于 Y:
T → int Y

Y 位于生成式末尾
所以:
FOLLOW(T) ⊆ FOLLOW(Y)

得到:
FOLLOW(Y) = { +, $, ) }
最终:
FOLLOW(E) = { $, ) }
FOLLOW(T) = { +, $, ) }
FOLLOW(X) = { $, ) }
FOLLOW(Y) = { +, $, ) }
可以简单总结为:
FIRST关注的是:这个符号或符号串最先可能出现什么终结符。
FOLLOW关注的是:这个非终结符解析结束后,接下来可能出现什么终结符。
这两个集合也是后续构造预测分析表的重要依据。
07-04 LL(1) Parsing Table
在前一节我们知道了什么是 First Sets 和 Follow Sets,接下来我们会在这个基础上构造完整的 LL(1) Parsing Table。
LL(1) Parsing Table 本身没有特别复杂。表格的行表示当前待解析的 non-terminal,列表示下一个输入 token,表中的元素则表示在当前情况下应该选择哪一条生成式进行解析。
例如对于表项:
M[A, t]其中 A 是当前待解析的 non-terminal,t 是当前输入 token,那么表中的内容就是在这种情况下应该使用的生成式。
LL(1) Parsing Table 的构建主要依赖上一节得到的 FIRST Sets 和 FOLLOW Sets。
对于一条生成式:
首先计算 FIRST(α)。
如果:
那么在:
中填入:
如果 α 可以推出 ε,也就是:
那么对于所有:
同样在:
中填入:
特别地,如果生成式本身为:
那么就需要根据 FOLLOW(A) 将这条 ε 生成式填入对应位置。
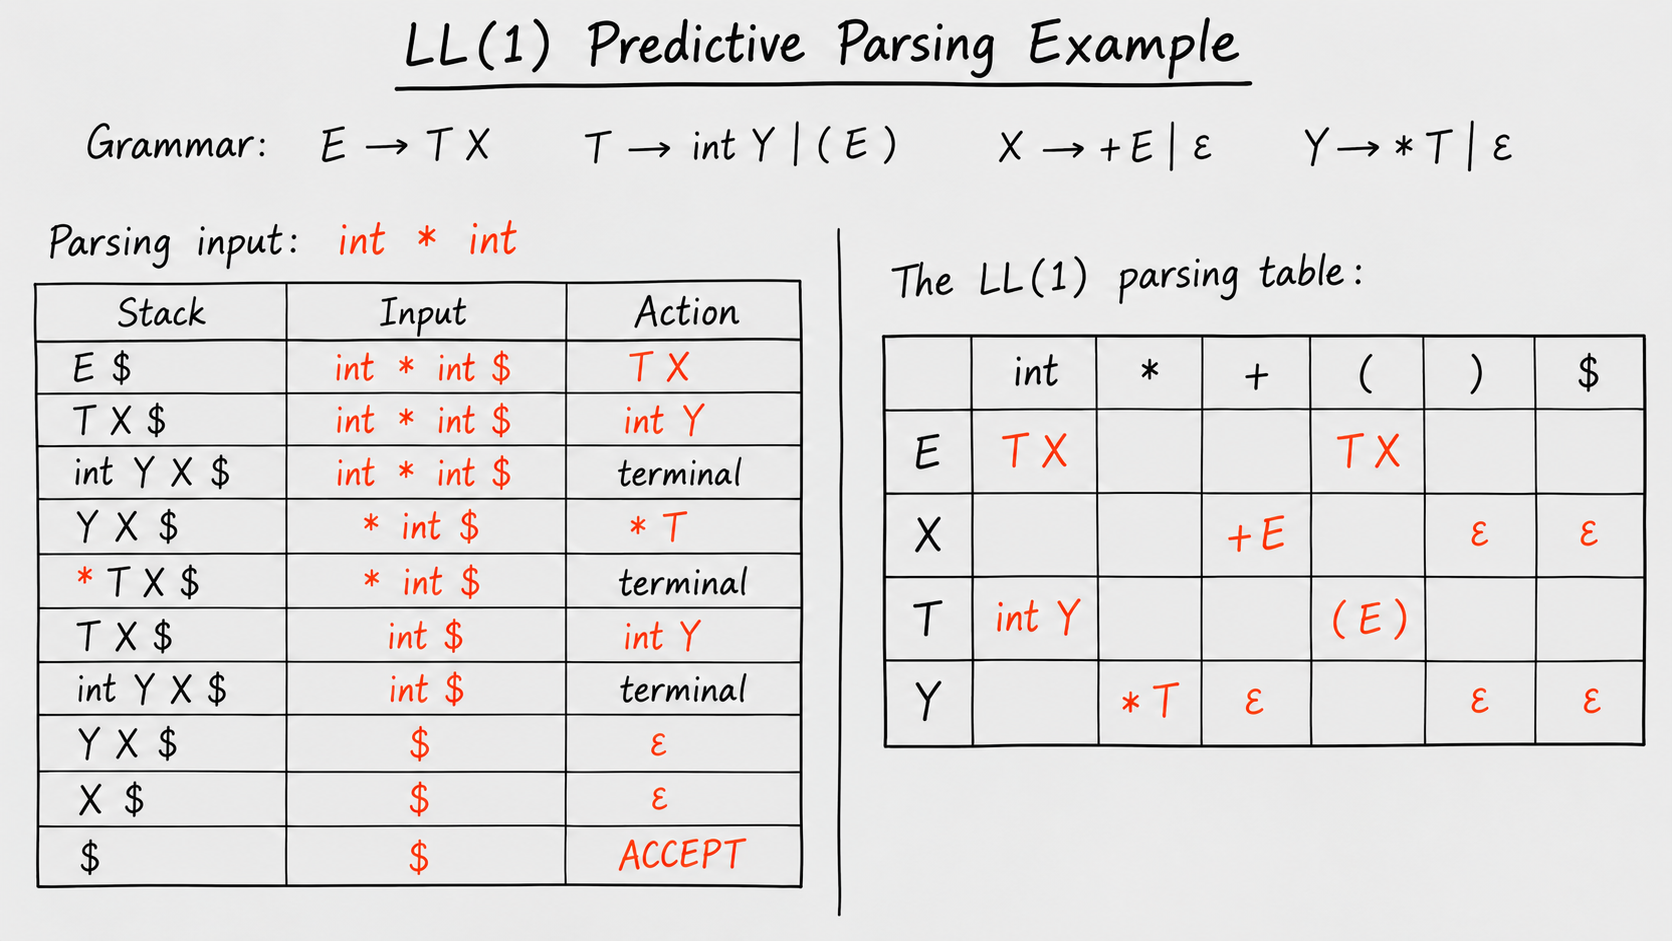
如果某个表项最终没有对应的生成式,则表示在当前 non-terminal 和输入 token 的组合下无法继续解析,也就是输入 token 序列出现了语法错误。
除此之外,如果同一个表项中需要填入两条不同的生成式,则说明当前文法存在预测冲突,不能直接作为 LL(1) 文法进行解析。
07-05 Bottom-Up Parsing
自底向上解析的算法比较有意思。
与自顶向下解析不同,自顶向下解析是从开始符号出发,不断选择生成式展开非终结符,最终尝试得到完整的 token 序列。
而 Bottom-Up Parsing 的思路则正好相反:它从输入的 token 序列出发,不断寻找能够与某个生成式右部匹配的片段,并将其归约为对应的非终结符。经过不断归约,最终如果能够得到文法的开始符号,就说明输入序列可以被该文法解析。
可以将这个过程直观理解为:不断对 token 序列进行“消融”,逐渐还原出它是由哪些生成式生成的。
归约过程的逆序,实际上就对应了生成该输入串时所使用的产生式顺序。
下面是一个简单的解析示例
假设有如下文法:
E → E + T
E → T
T → int
输入:
int + int自底向上的归约过程可以写成:
int + int
↓
T + int        使用 T → int
↓
E + int        使用 E → T
↓
E + T          使用 T → int
↓
E              使用 E → E + T
最终整个输入串被归约成开始符号 E,因此:
int + int可以被该文法正确解析。
如果把归约过程反过来看:
E
⇒ E + T
⇒ T + T
⇒ int + T
⇒ int + int
就可以看到,它实际上对应了一次从开始符号到输入串的推导过程。
07-06 Shift-Reduce Parsing
Shift-Reduce Parsing 是一种典型的自底向上解析方法。它仍然需要依赖已经定义好的生成式,并不是根据输入 token 反过来“生成”文法。
它的核心思路是维护一个栈,不断在 Shift 和 Reduce 两种操作之间进行选择:
Shift:
将当前输入 token 压入栈中,并继续读取下一个 token

Reduce:
如果栈顶的一段符号与某个生成式右部匹配,
就将这段符号替换为该生成式左侧的 non-terminal
例如对于文法:
E → E + T
E → T
T → int
输入:
int + int解析过程可以表示为:
Stack        Input         Action
---------------------------------
             int + int $   Shift

int          + int $       Reduce T → int

T            + int $       Reduce E → T

E            + int $       Shift +

E +          int $         Shift int

E + int      $             Reduce T → int

E + T        $             Reduce E → E + T

E            $             Accept
可以看到,Shift 的作用只是不断读取输入,而真正的“消融”发生在 Reduce 阶段。
当栈顶出现:
E + T并且文法中存在:
E → E + T就可以进行归约:
E + T
↓
E
不断重复 Shift 和 Reduce,如果最后输入已经读取完毕,并且栈中成功归约为开始符号,就说明解析成功。
因此,Shift-Reduce Parsing 可以简单理解为:
一边从左向右读取 token,一边利用已有生成式不断对栈中的符号进行归约,最终尝试将整个输入串还原为开始符号。
实际解析时,真正需要解决的问题是:什么时候应该 Shift,什么时候应该 Reduce。 后续的 LR Parsing 就是通过状态和 Parsing Table 来决定这些操作。