CS143 Chapter 08
08-01 Handle
在 Shift-Reduce Parsing 中,Handle 指的是当前句型中下一步应该被 Reduce 的符号串。
假设存在生成式:
当前句型中存在:
如果将 β 归约为 A:
正好对应正确推导过程的逆序,那么其中的 β 就是当前句型的 Handle。
需要注意的是,能够匹配某个生成式右部的符号串不一定就是 Handle。Handle 必须是当前正确解析过程中下一步应该进行归约的位置。
因此,Shift-Reduce Parsing 的一个核心问题就是:
如何判断当前栈顶是否已经形成 Handle?
而后续的 LR Parsing 就是用状态和 Parsing Table 来解决这个问题。
08-02 Recognizing Handles
在前面我们知道,Handle 指的是当前句型中下一步应该被归约的那一段符号串。因此,Bottom-Up Parsing 的一个核心问题就是:如何判断当前栈中的哪一部分构成了 Handle。
在 Shift-Reduce Parsing 中,解析器会不断将输入 token 压入栈中,并尝试在合适的时候进行归约。归约时所使用的那一段栈中符号,必须正好对应某个生成式右部,并且它还必须是当前正确推导过程中的下一步归约目标。也就是说,不是所有看起来能匹配生成式右部的字符串都是 Handle。
例如对于:
E → E + T
E → T
T → int
如果当前栈中已经形成:
E + T那么它可以与生成式:
E → E + T匹配,此时就可以将:
E + T归约为:
E这时,E + T 就是当前的 Handle。
因此,Recognizing Handles 这一步,本质上就是要判断:
当前栈顶的符号串,是否正好构成当前应该被 Reduce 的 Handle。
而后续的 LR 系列解析方法,就是通过状态和分析表来帮助解析器完成这件事。
08-03 Recognizing Viable Prefixes
Handle 的识别并不是直接凭感觉完成的,而是要先解决另一个问题:当前栈中的内容是否是一个合法的可行前缀(Viable Prefix)。
Viable Prefix 可以直观理解为:在正确的 Shift-Reduce Parsing 过程中,可能合法出现在栈中的符号串。 也就是说,它表示的是一种“目前为止还没有出错,并且还可能继续完成解析”的中间状态。
因此,Recognizing Viable Prefixes 这一节的重点,其实就是说明:
如何用状态转换图去识别一个符号串是否是 viable prefix。
这里就会引入 Item 的概念。Item 是“带位置标记的生成式”,本质上只是描述“某条产生式当前识别到了哪里”。
例如对于生成式:
E → E + T它可以写成几个不同的 Item:
E → · E + T
E → E · + T
E → E + · T
E → E + T ·
其中的 · 表示当前识别的位置。 · 左边表示已经识别完成的部分,右边表示后续还需要识别的部分。
通过这些 Item,就可以构造出一个状态转换图。这个图本质上刻画了:
当前已经识别出的符号串,是否仍然是一个合法的 viable prefix。
从这个角度看,这一节确实可以理解为:说明如何画出识别 viable prefixes 的状态转换图。在理论上,它通常先表现为一个 NFA,后续再逐步转化为更适合解析使用的状态集合形式。
08-04 Valid Items
前面说到,Item 只是“带位置标记的生成式”。但并不是每一个 Item 都和当前解析状态有关,因此又引入了 Valid Item 的概念。
Valid Item 可以理解为:
对于当前 viable prefix 来说,确实可能描述当前解析进度的 Item。
换句话说,Item 是文法中理论上可能出现的“识别位置”,而 Valid Item 则是:
在当前这个栈状态下,真正可能成立的那些 Item。
例如当前栈中已经识别出:
E +那么:
E → E + · T就是一个 Valid Item,因为它准确描述了当前的识别进度:E + 已经识别完成,接下来还需要一个 T。
因此可以简单区分为:
Item
= 带位置标记的生成式

Valid Item
= 对当前 viable prefix 有效的 Item
后续 LR Parsing 中的一个状态,实际上就是一组 Valid Items。这些 Valid Items 一起描述了解析器当前可能处于的识别进度。
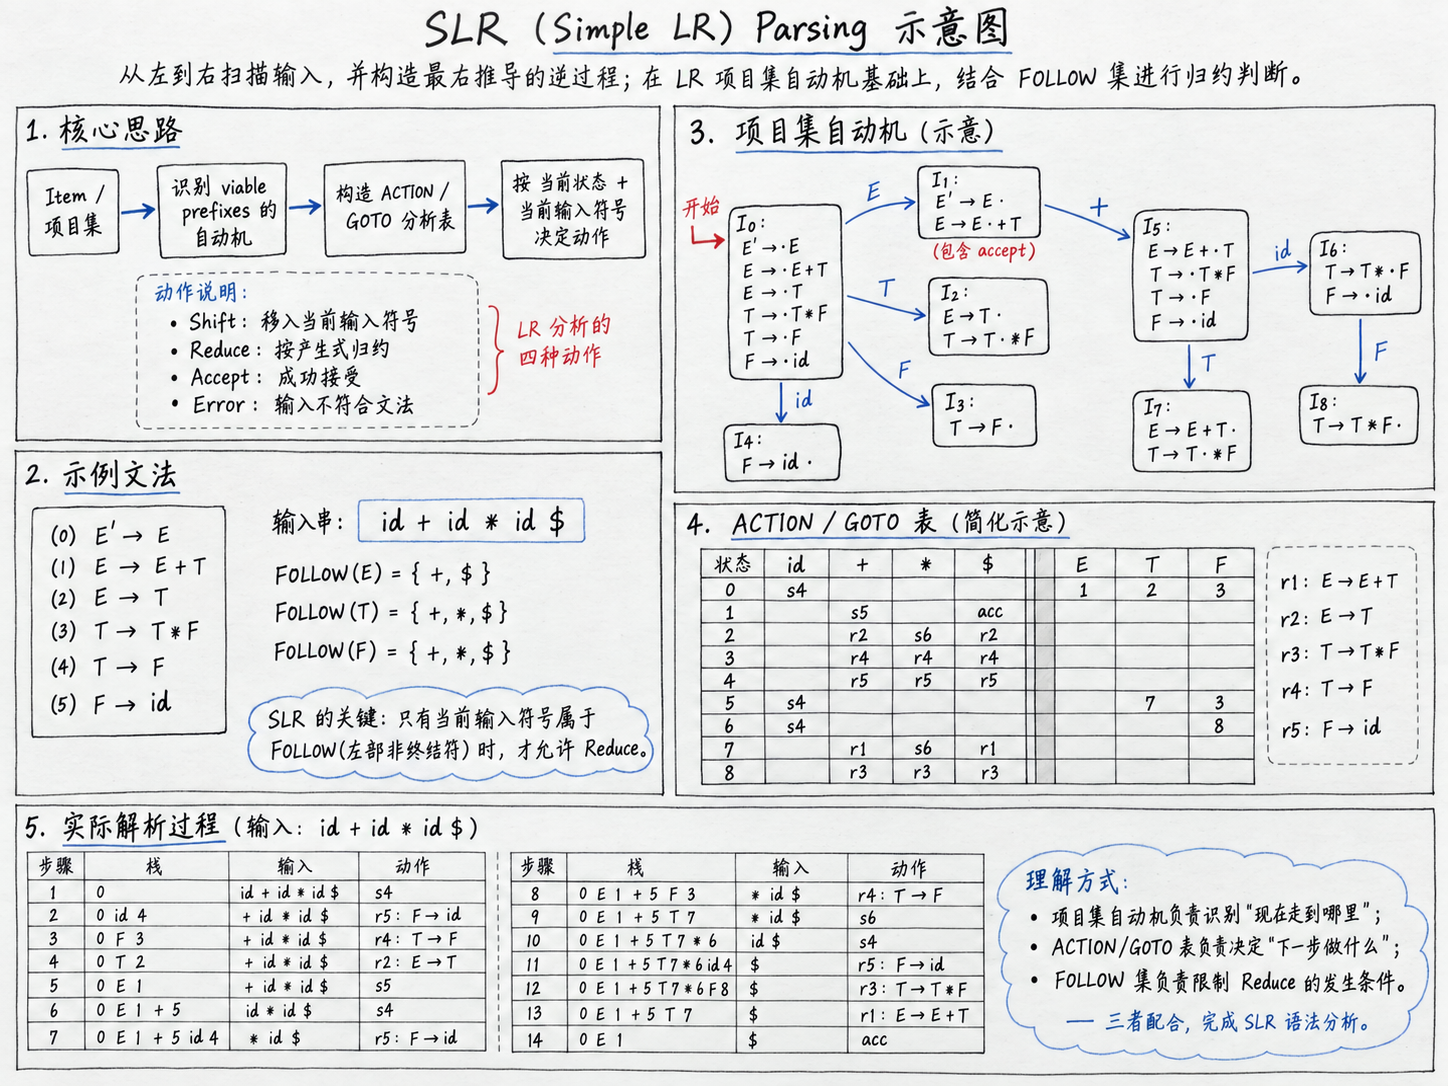
08-05 SLR(Simple LR) Parsing
在前面几节中,我们已经知道了 Handle、Viable Prefix、Item 和 Valid Item 的含义。接下来,SLR Parsing 就是在这些概念的基础上,进一步构造出能够实际进行解析的分析方法。
SLR 中的 “LR” 可以理解为:从左到右扫描输入,并构造最右推导的逆过程。 其中 “Simple” 表示它是 LR 方法中较为基础、较为简单的一种。
SLR Parsing 的核心思路是:
先利用 Item 构造状态集合,也就是识别 viable prefixes 的自动机;
再根据这些状态生成分析表;
最后在解析时,根据“当前状态 + 当前输入符号”决定执行哪一种动作。
这些动作通常包括:
Shift
Reduce
Accept
Error
其中:
Shift表示将当前输入 token 移入栈中;Reduce表示按照某条生成式进行归约;Accept表示输入串已经成功解析;Error表示当前输入不符合文法规则。
SLR 与更一般的 LR 方法相比,特点在于它在进行 Reduce 决策时,会借助 FOLLOW 集 来判断某条归约是否可以发生。也就是说,只有当当前输入符号属于对应非终结符的 FOLLOW 集时,才允许进行相应的 Reduce。
因此可以把 SLR 简单理解为:
在 LR 项目集自动机的基础上,再结合 FOLLOW 集来构造分析表的一种较简单的 LR 解析方法。
它比普通的 Shift-Reduce Parsing 更系统,也比完整的 LR(1) 更容易实现,因此通常作为学习 LR Parsing 的第一步。
08-07 SLR Improvements
SLR 可以理解为在 LR(0) Parsing 的基础上,对 Reduce 的条件进行了进一步限制。
在 LR(0) 中,只要当前 DFA State 中存在已经识别完成的 Item:
X → β ·就认为当前可以按照:
X → β进行 Reduce。这种判断比较宽松,有时虽然生成式已经识别完成,但当前输入 token 并不适合进行归约,因此可能产生 Shift/Reduce Conflict。
SLR 在此基础上加入了 Follow Sets。假设当前输入 token 为 t,那么只有同时满足:
X → β ·
t ∈ FOLLOW(X)
时,才允许执行:
Reduce X → β否则就不能直接 Reduce,而是继续判断是否应该执行 Shift。
因此 SLR 的改进可以简单理解为:
LR(0):
生成式识别完成
→ Reduce

SLR:
生成式识别完成
+
当前 token ∈ FOLLOW(X)
→ Reduce
通过 FOLLOW 集限制 Reduce 的发生条件,可以避免一些 LR(0) 中过早发生的归约,从而减少 Shift/Reduce Conflict。如果按照这套规则仍然产生冲突,那么该文法就不是 SLR Grammar。